
Я знала, что n8n мониторинг - это не штука про магию, а про здравый смысл и дисциплину. Для российских специалистов тема особенно чувствительная: у нас есть 152-ФЗ, привычка всё подтверждать цифрами и немного скепсиса к «умным» системам без объяснения, что внутри. В этой статье я показываю, как за 5 шагов собрать алерты в n8n так, чтобы не утонуть в шуме, не нарушить закон и при этом реально экономить часы. Разбираю, что мониторить, где хранить ключи, как фильтровать и логировать, чтобы процессы были прозрачны, а метрики честные. Это актуально, потому что автоматизация наконец переместилась из хайпа в повседневность, и теперь нужна простая, рабочая методика, а не «два клика и готово». Текст для тех, кто строит операционку, ИИ-агентов и интеграции, любит понятные схемы и ценит белые данные больше быстрых лайков.
Я начинала как внутренний аудитор, и это навсегда испортило мой романтический взгляд на автоматизацию: если система не объясняет, что она делает, я ей не верю. С n8n вышло похоже: он гибкий, дружелюбный, с большим комьюнити, но если подойти без правил, алерты за пару вечеров превращаются в белый шум. В первый день теста у меня прилетело 17 уведомлений, во второй - ноль, хотя инциденты были. Я села с кофе (успел остыть), пересобрала триггеры, добавила фильтры, разнесла каналы и настроила логирование, чтобы сама себе не противоречить в отчете. Это заняло около двух часов и спасло не только нервы, но и репутацию моей «умной» системы.
Дальше будет методика без маркетинга: как поставить цель мониторинга, выбрать источники, настроить алерты, отфильтровать шум, завести метрики и логи, учесть 152-ФЗ и белые данные, а потом спокойно жить. Я рассказываю от первого лица, показываю рабочие связки и тонкие места, даю формулы отсечения лишнего и подсказки по n8n настройка - без магии и «пару кликов». Иногда добавляю бытовые детали и короткие самопоправки в скобках - это помогает не терять нить. Получится у тех, кто готов немного подумать на старте и поддерживать порядок, как в нормальной системе контроля версий, только для алертов.
Зачем нужен n8n мониторинг в России и что болит на практике?
Я часто вижу одну и ту же картину: автоматизация есть, а мониторинга нет, и потому люди узнают о сбое от клиента, а не от системы. В российских компаниях к этому добавляется забота про 152-ФЗ и white-data-зону: если workflow гоняет персональные данные, значит, надо хранить локально, шифровать и логировать доступы. Плюс разнородные источники - CRM, 1С, телеметрия, вебхуки, внутренние базы - тянут одеяло в разные стороны, и без общей картины событий легко либо выйти в лавину ложных алертов, либо тихо пропустить критическое событие. Я заметила, что корень проблемы не в n8n, а в том, что мы не формулируем цель и метрики: что считаем инцидентом, на что реагируем сразу, а что складываем в отчеты. Когда цель есть, настройка превращается из хаоса в набор повторяемых шагов, и алерты перестают мешать жить. Дальше разберем, как это собрать так, чтобы и ответственность не потерять, и звук уведомлений не ненавидеть.
Чтобы визуально показать, как выглядит рабочая схема мониторинга событий и алертов, я привожу один из моих базовых рабочих процессов. Он простой по структуре, но хорошо иллюстрирует идею о том, что каждая нода делает ровно одну понятную вещь, а связи читаются без магии.
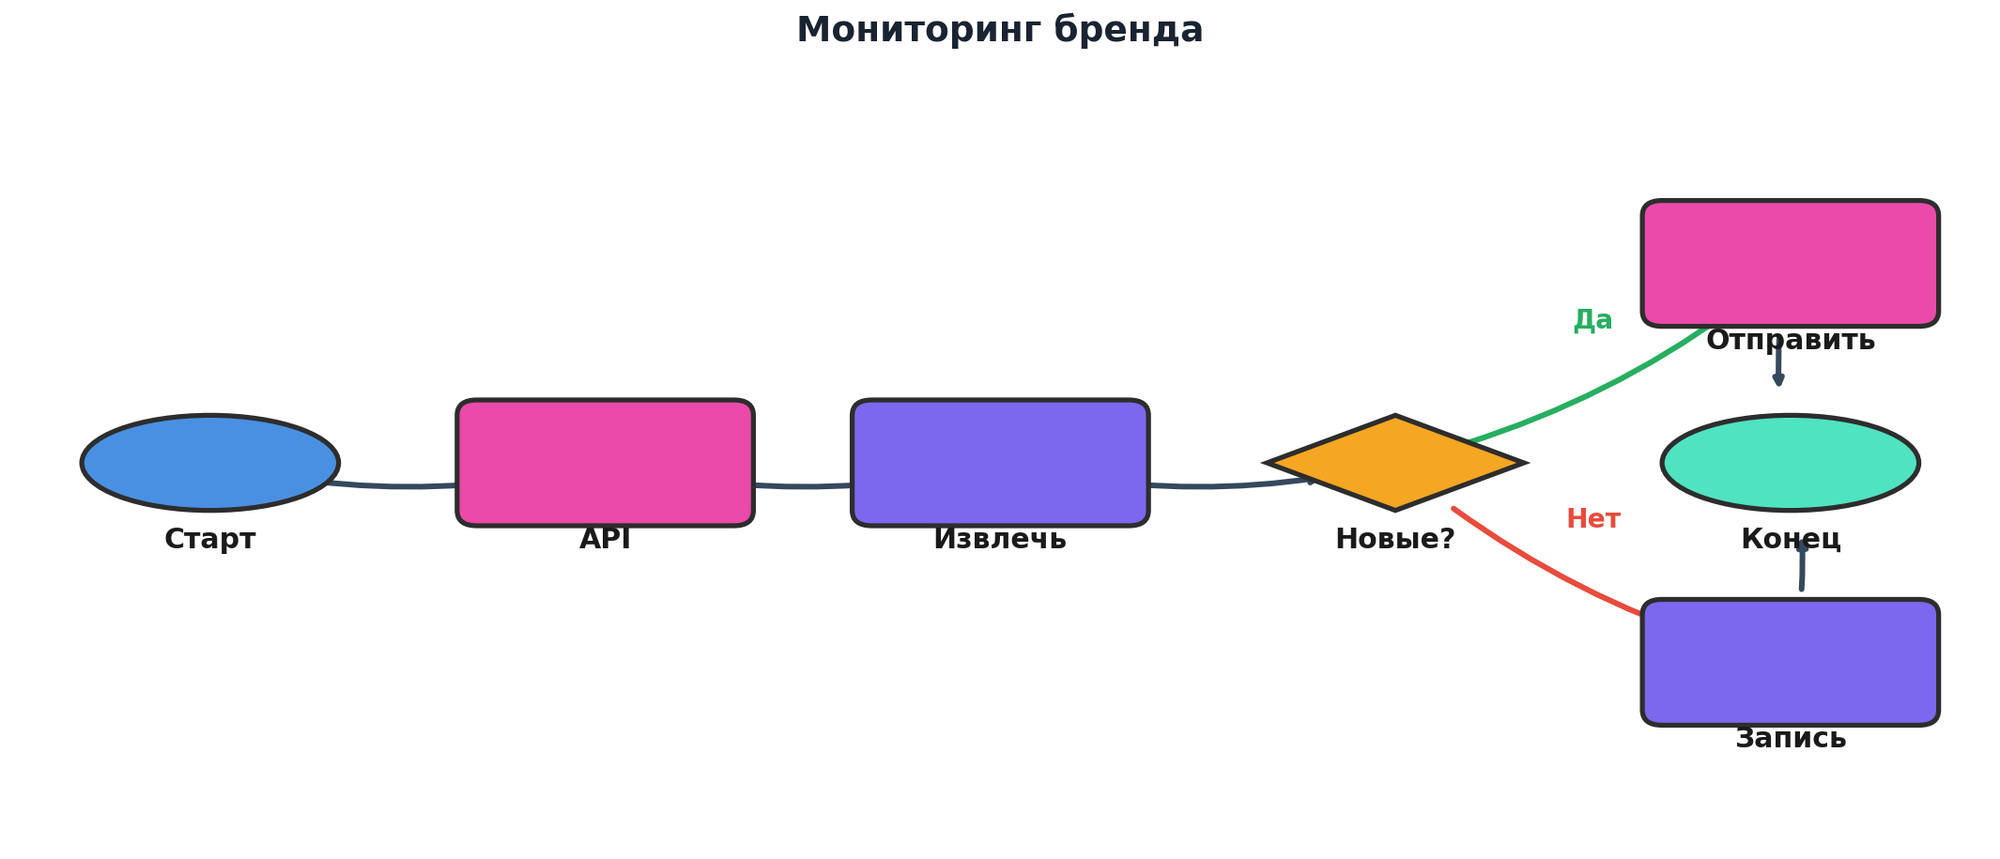
Теперь к акценту, без которого система быстро теряет смысл и лезет в красную зону уведомлений. Я сформулировала для себя правило рабочего цикла, и оно удерживает чистоту алертов в пределах разумного порога. Эта рамка звучит просто, зато дисциплинирует и команду, и меня.
Алерт - это не «новость», а «повод к действию». Если после уведомления никто не делает шаг, оно лишнее. Все остальное - отчеты и статистика, но не тревога.
Получается, что маркер качества мониторинга - не количество сигналов и не сложность нод, а доля алертов, которые заканчиваются конкретным действием. Если эта доля падает, значит, триггеры забиты шумом, а фильтры слабые. Если растет - всё в порядке, и можно смело масштабировать.
Что именно мониторим и почему это важно для ПДн?
Я начала с инвентаризации событий и объектов: что относится к бизнес-критичным процессам, где у нас SLA, какой риск несет задержка или потеря данных. Это может быть смена статуса заявки, превышение порога ошибок в API, необычная динамика в таблице продаж или резкий всплеск отрицательных упоминаний в соцсетях. Дальше я отмечаю, затрагиваются ли персональные данные и на каком уровне: идентификатор пользователя, контакт, контент. Если да - я сразу закладываю локальное хранение, минимизацию полей и обезличивание на этапе обработки, чтобы в логах и алертах не летали ФИО и номера телефонов. Это критично, потому что в России оператор несет ответственность за учет действий с ПДн, и мониторинг - часть этой картины, а не отдельный мир. Поэтому в n8n у меня есть базовые функции-«шаблоны» для маскирования полей, чтобы не думать об этом руками каждый раз. Мониторинг не должен раскрывать данные - он должен сообщать о событии и давать ссылку на источник внутри защищенного периметра. Когда это правило закреплено, все остальные настройки становятся проще и быстрее, а аудит перестает быть страшной историей.
Какие метрики брать, чтобы не утонуть в алертах?
Я отбираю три уровня метрик: операционные (работает ли workflow, сколько попыток, время ответа), бизнесовые (сколько событий фактически обработано, какой эффект) и защитные (сколько отсеяли фильтры, сколько дублей мы не пропустили). В n8n это удобно складывать в отдельную таблицу и визуализировать внешним инструментом, но даже без графиков становится понятно, где узкое место. Затем я назначаю пороги: мягкий, средний и жесткий - и решаю, кому и куда идут алерты на каждом из уровней, чтобы руководитель не получал поток технических сообщений ночью. Если метрика не ведет к действию, она переезжает из алерта в отчет. Еще одна деталь - я всегда считаю долю «пустых» алертов, которые не вызвали изменения в системе или в расписании. Если доля превышает оговоренный уровень, значит, фильтры недостаточно точны или триггер слишком широк, и пора сужать условия.
Как выбрать источник событий и настроить безопасный доступ?
На практике я начинаю с карты источников: вебхуки от сервисов, крон-проверки API, очереди сообщений, базы данных, логи приложений и системный мониторинг инфраструктуры. Каждый источник я оцениваю по четырем пунктам: стабильность, формат данных, ограничения по частоте и юридические требования. Если сервис хранит ПДн, я проверяю, что он локализован в РФ, а доступ к нему настроен через ограниченные токены и VPN. Для критичных событий стараюсь иметь два канала: первичный и резервный с меньшей детализацией, чтобы не было ситуации «всё зависит от одного webhook». В n8n это решается ветвлением и приоритетами, а дальше остается только договориться о скорости опроса и лимитах. Я иногда фиксирую эти решения в короткой вики - через неделю так легче вспомнить, почему выбрали именно такой вариант.
Для наглядности покажу архитектурный эскиз, который хорошо ложится на российские реалии с локальными базами и сегментами сети. Он помогает быстрее объяснить коллегам, где что живет и почему мы так настраиваем доступы.
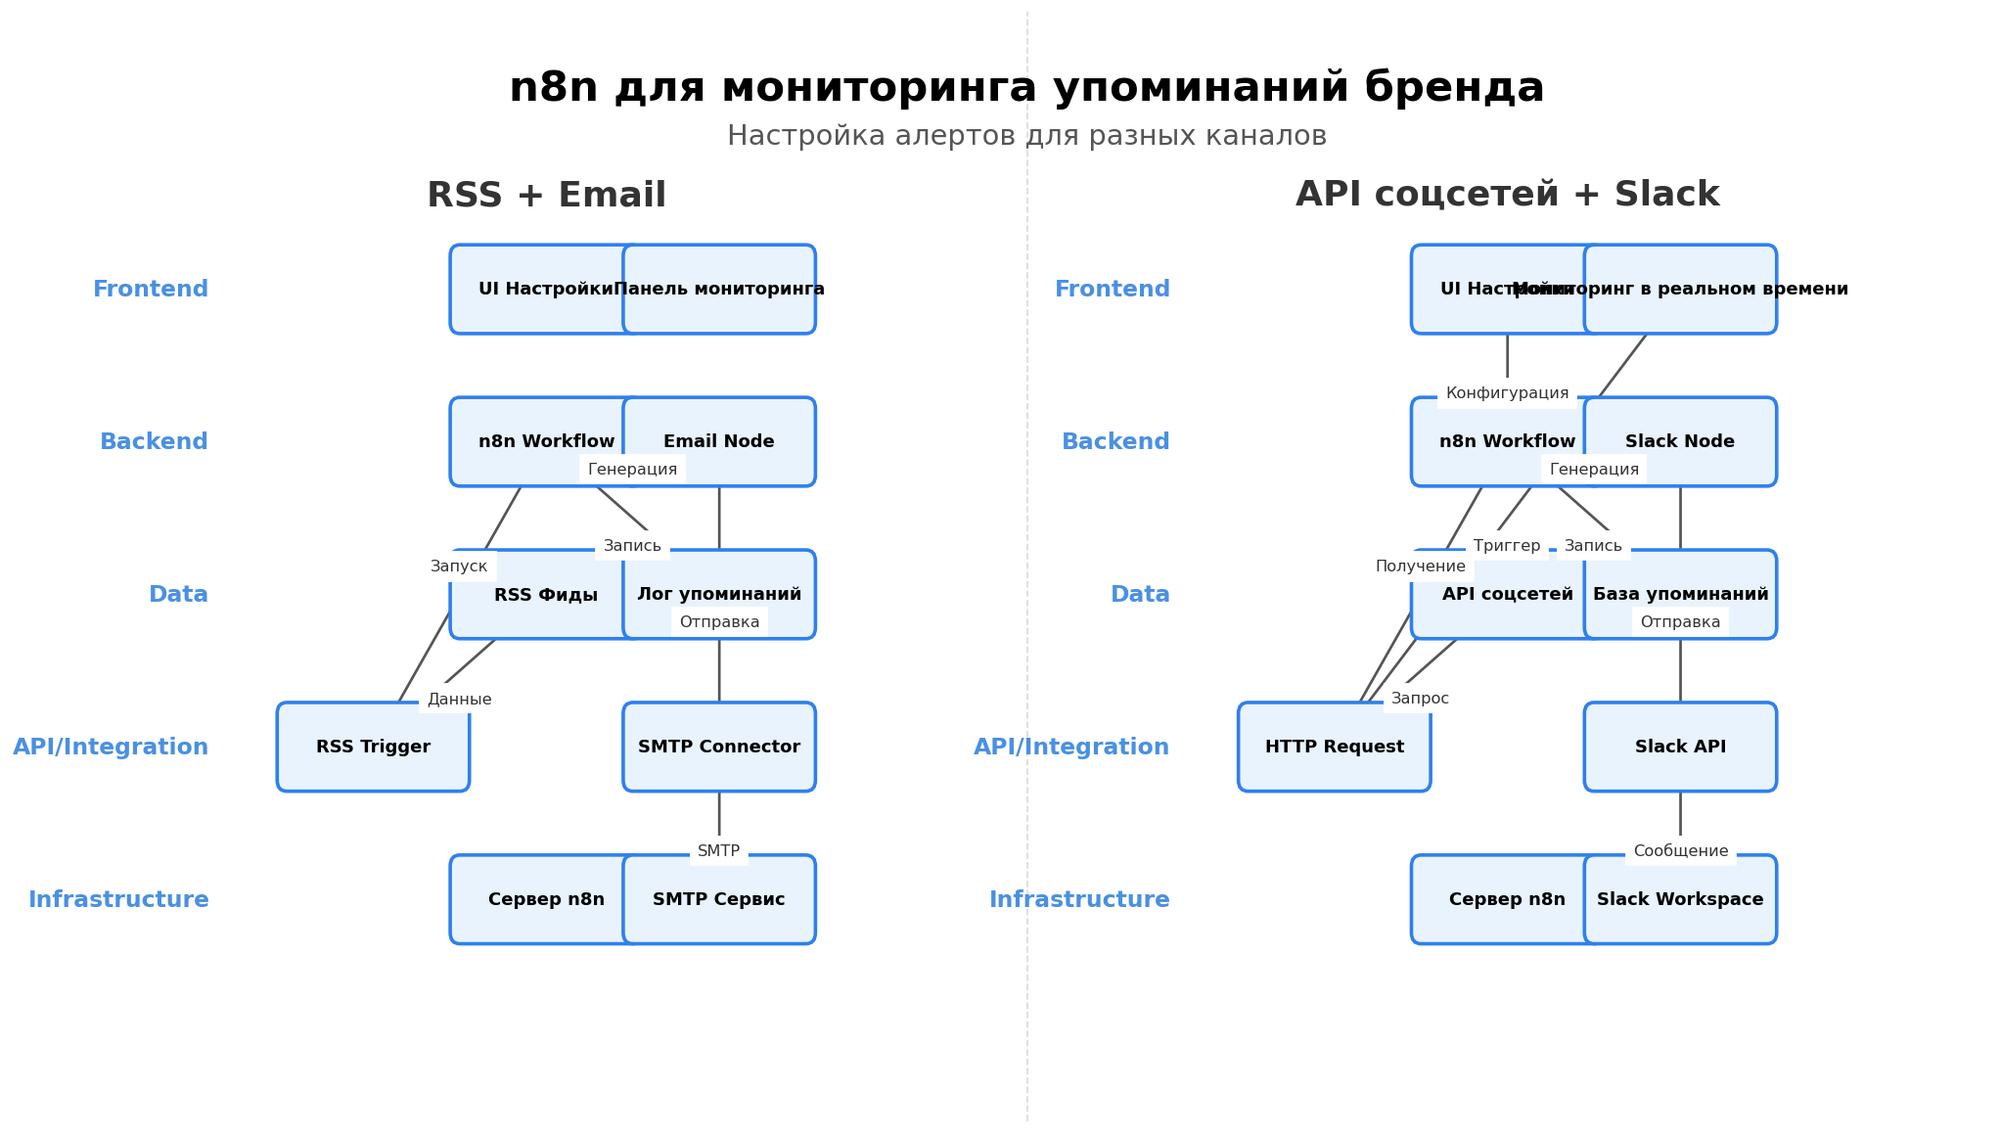
И еще один тезис, который я всегда проговариваю команде перед стартом. Он звучит банально, но экономит часы отладки и спасает от излишних доступов, особенно когда в проекте много людей и сервисов. Один источник - одна причина его использовать, один ответственный, один способ ревокации ключа. Так не придется ночью вспоминать, где лежит токен и почему у вашего бота вдруг появился лишний доступ.
Где хранить ключи и токены, чтобы спать спокойно
Я предпочитаю два уровня защиты: секреты окружения и менеджер секретов, который живет в периметре компании. В n8n это реализуется через переменные окружения и креденшелы, где доступ по ролям ограничивает редактирование и просмотр. Я принудительно разделяю ключи по рабочим пространствам: что относится к тесту, что к продакшену, и никогда не смешиваю. Для доступа из облака к локальным источникам использую туннели с IP-ограничениями и аудитом входов. Перед каждым релизом проверяю, что токены подписаны и есть понятная процедура их отзыва - без этого рано или поздно произойдет «утечка по привычке». В конце концов, любая автоматизация должна быть перезапускаема, а для этого ключи нужны управляемые. И да, я один раз потеряла ключ в заметках, после чего завела отдельный регистр - мелочь, а спасает.
Секрет - это не файл в облаке с названием secret. Секрет - это объект с владельцем, сроком жизни, хранением и процедурой ревокации. Остальное - удобные иллюзии.
Как учесть локализацию и 152-ФЗ без лишней бюрократии
Я расставляю маркеры в workflow там, где потенциально проходят ПДн: входящий запрос, узел преобразования, отправка в чат, запись в лог и хранилище. Если поле несет идентификатор, я сразу маскирую значения в тексте алерта и оставляю ссылку на внутреннюю карточку, доступ к которой уже регулируется правами. При передаче в государственные системы закладываю обезличивание на стороне workflow до формирования пакета. Это кажется долгим, но на деле пара узлов и шаблонов решают 80% задач. Локализация - про то, где лежит первичный массив, а не копия в облаке для графиков. Поэтому графики и дашборды, если очень надо, я строю на агрегированных данных или на тех, что не позволяют идентифицировать человека. И все это фиксирую в политике обработки, чтобы у аудитора не было лишних вопросов.
Как собрать алерты в пять шагов и не сорвать сон?
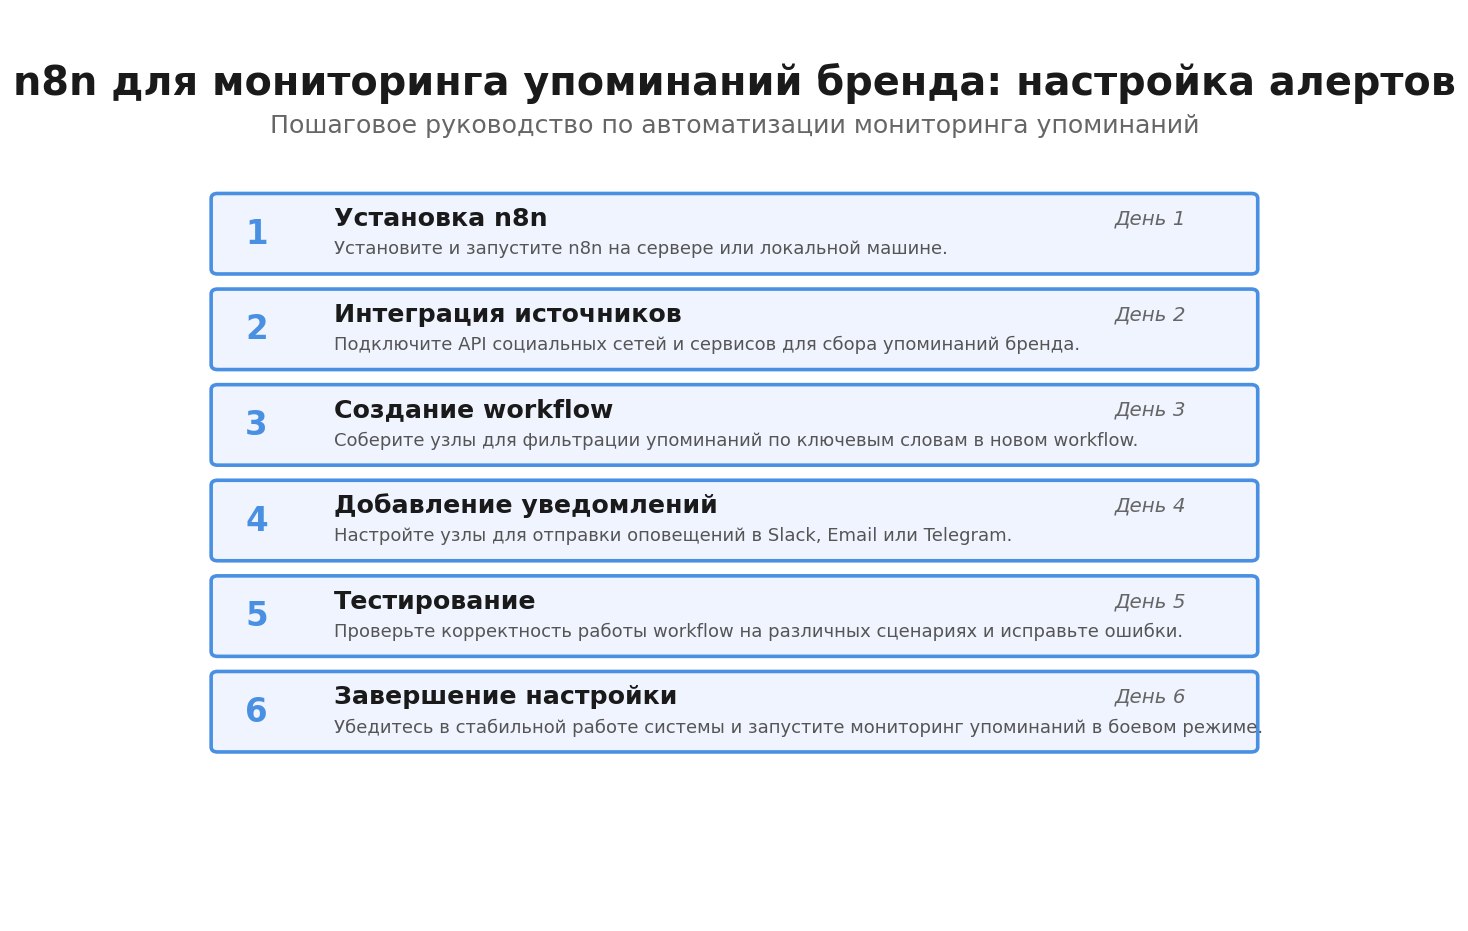
Если говорить коротко, весь процесс укладывается в понятные пять шагов. Я упрощаю формулировки, чтобы сохранить фокус, и даю конкретику, с которой можно сесть вечером и настроить на рабочем проекте. Ниже - мой базовый алгоритм, который работает и для технических событий, и для бизнес-метрик, и для мониторинга упоминаний бренда. Включая случаи, когда есть n8n настройка агента под ИИ-задачи и нужно отслеживать деградацию качества ответов.
- Определить цель алерта и список действий после него - без этого уведомление не нужно.
- Выбрать триггер: webhook, расписание, событие из очереди - и задать частоту.
- Добавить фильтры и дедупликацию: условия, окна времени, ключи уникальности.
- Настроить каналы: Telegram, почта, внутренний чат - разнести по приоритетам.
- Включить логирование и метрики: считать шум, смотреть на долю «пустых» сигналов.
Чтобы было проще представить, как это собирается в n8n, покажу наглядную пошаговую схему. Она покрывает и базовые узлы, и ветки с фильтрами, и отправку уведомлений, так что картинка ближе к реальной жизни.
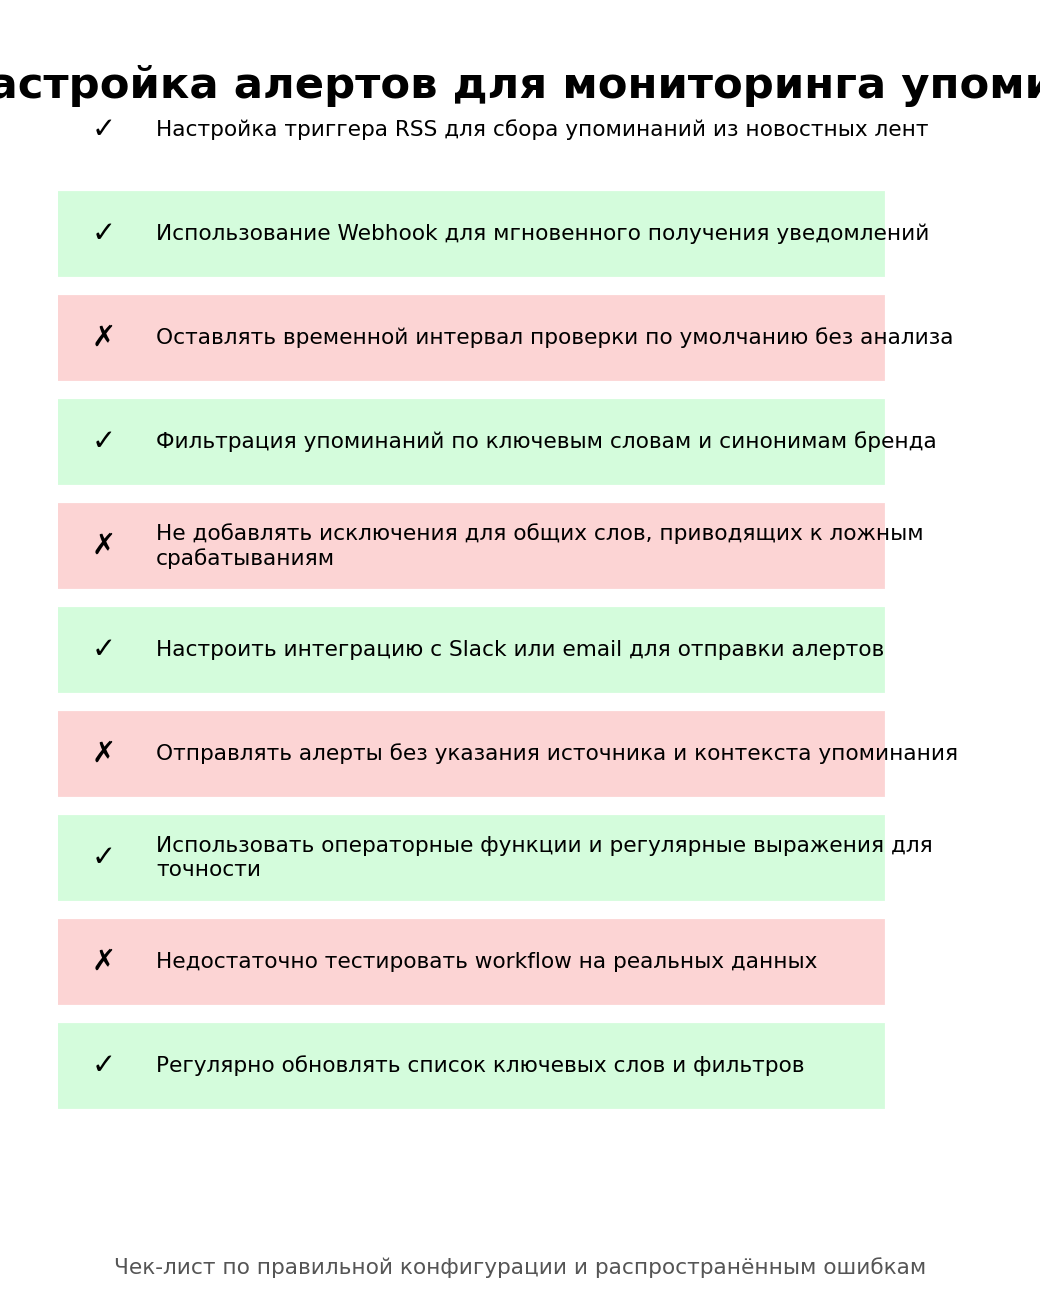
А это - короткий чек-лист на одном экране, с которого удобно стартовать, если хочется быстро собрать MVP и не влезать в тонкости сразу. Он дополняет схему сверху и помогает не забыть про мелкие, но необходимые шаги, вроде логов и таймаутов.
Настройка триггера: webhook, cron или событие из CRM?
Я выбираю триггер по формуле «где событие рождается»: если система умеет пушить вебхуки - беру их, потому что это самый быстрый путь к свежим данным. Если нет - ставлю расписание с разумной частотой, чтобы не перегружать API и не ранить бюджет. Для внутренних очередей событий использую подписку на топики с авто-повторами при ошибках. В n8n это делается через стандартные ноды HTTP Trigger, Cron, или интеграции с брокерами - дальше только границы времени и ретраи. Триггер должен срабатывать только тогда, когда у нас есть шанс что-то изменить в процессе. Поэтому я отсекаю «интересно знать» и оставляю только «нужно действовать» - остальное уйдет в ежесуточный отчет и не разбудит никого ночью.
Фильтры и дедупликация: как отсечь шум
Я люблю фильтры по окнам времени и ключам уникальности: например, алерт о падении сервиса уходит один раз за 10 минут, даже если инцидентов 15. Это делается нодой, которая складывает хэш события, и следующей веткой, которая проверяет, был ли он в окно. Дальше - условия по полям: статус, источник, число повторов, доля ошибок. Если условие можно прочитать, его можно поддерживать, если оно выглядит как заклинание - через месяц никто не вспомнит смысл. Поэтому я стараюсь формулировать фильтры словами из процесса, а не из кода: «новая заявка без ответа 15 минут» звучит лучше, чем «status=new AND now-created_at>900». Оно и на планерке объяснить легче, и поддерживать спокойнее.
Какие инструменты в связке с n8n реально работают в РФ?
Я перепробовала разные комбинации и оставила те, которые не ломаются о российские реалии. Для уведомлений комфортно использовать Telegram - каналы и чаты с разными правами, но с оговоркой про маскирование ПДн и ограничение доступа. Для хранения и агрегирования событий хорошо подходят локальные базы или российские облака, а для быстрых таблиц - Airtable как слой представления, если данные не персональные. Иногда к связке подключаю ИИ-агента в n8n, чтобы он оценивал тональность упоминаний или классифицировал события по типам, и это реально экономит время при анализе. Но любой агент должен быть прозрачным: откуда берет данные, как считает, где хранит память - для этого помогает n8n настройка zep, когда нужна долговременная память диалогов. Я фиксирую границы ответственности: что делает n8n, что делает внешний сервис, и чем можно пожертвовать при отказе, чтобы бизнес не остановился.
Чтобы визуально показать разницу между экосистемами, удобно взглянуть на схемы сравнения. Я оставляю картинку, которая помогает быстро обсудить с командой выбор инструмента под мониторинг.
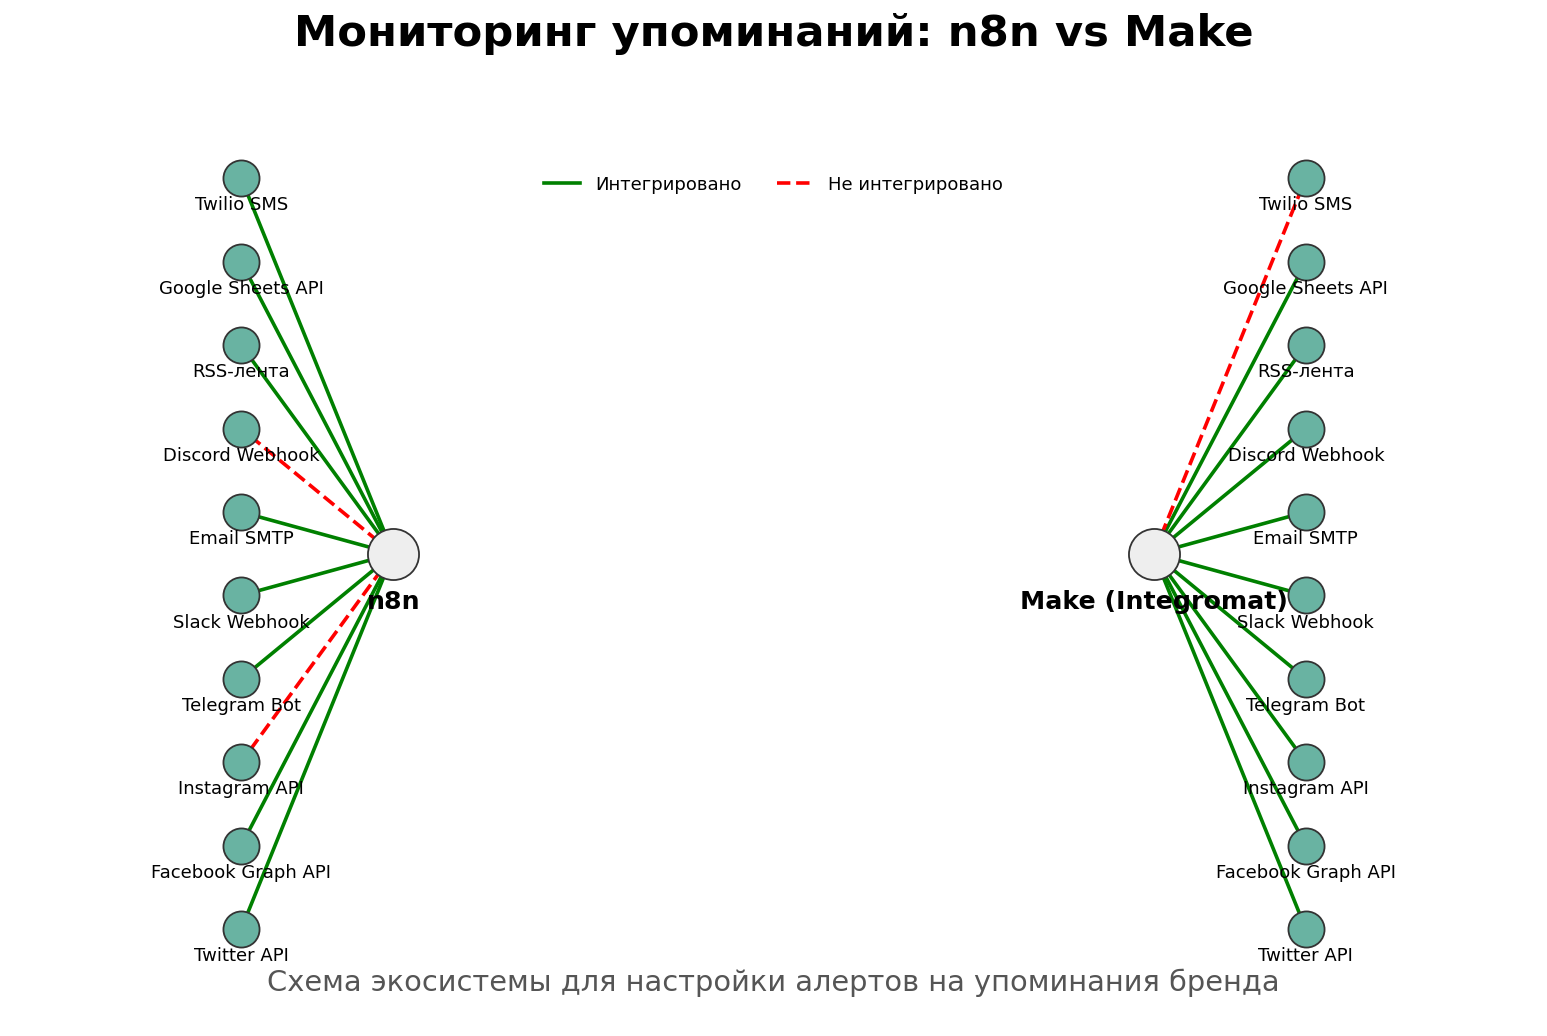
Еще один момент, которым я делюсь с командами перед выбором инфраструктуры. Мы иногда так увлекаемся фичами, что забываем про поддерживаемость и владение. Поэтому я проговариваю критерий на берегу и прошу его подписать глазами тех, кто будет дежурить.
Инструмент подходит, если его может поддержать тот, кто не писал этот workflow. Всё остальное - временно и на энтузиазме автора.
Когда уместен Make, а когда - n8n tool настройка?
Я не из тех, кто объявляет «только open-source»: иногда Make удобнее, когда нужен быстрый старт, готовые коннекторы и мягкая кривая входа. Но если компания хочет контроль, локализацию и гибкость, n8n выигрывает за счет развертывания в своем периметре и тонкой настраиваемости логики. Когда стоит задача собрать мониторинг из нестандартных источников, сделать нетривиальные фильтры, вести логи в своей базе и подружить всё с внутренними сервисами, n8n tool настройка даст больше свободы. Правило простое: прототип - где быстрее, прод - где безопаснее и прозрачнее. Если инфраструктура уже умеет крутить контейнеры и у вас есть DevOps, развернуть n8n и встроить в процессы несложно, а контроль становится ощутимо выше.
Как подружить n8n с Telegram и Airtable без сюрпризов
Я выбираю Telegram для критичных алертов с метками приоритета и тема-каналами, чтобы не мешать разным ролям. Перед первым релизом прогоняю пару недель в «тихом режиме», считываю шум, отрезаю лишнее. Внутри самих сообщений оставляю только ключи и ссылки, чтобы не провоцировать попадание ПДн в чаты. Для отчетов и быстрых витрин использую таблицы, и настройка ноды Airtable в n8n занимает несколько минут, если данные обезличены. Там, где есть персональные поля, Airtable у меня не живет - это граница здравого смысла. Если нужен дополнительный слой анализа, подключаю агента на классификацию и вынос суждений, но изолирую его от первичных данных и даю только необходимые поля.
Если нужна дорожная карта по экосистеме MAREN и моим шаблонам интеграций, я оставляю спокойную ссылку на мой сайт - в разделе про автоматизация через n8n все структурировано без лишних слов. Ссылка кликабельная и аккуратная: автоматизация через n8n.
Как проверить, что мониторинг честный: метрики, логи, отказы?
Я использую три слоя проверки: метрики реакции, качество фильтрации и устойчивость к отказам. Метрики реакции - это время от события до алерта и время до первого действия человека, и они редко совпадают, но вместе дают хорошую картину. Качество фильтрации - доля ложных тревог и пропусков, и если одно падает, второе обычно растет, поэтому я держу оба числа на виду. Устойчивость - способность системы отработать при внутренних сбоях: повторить попытку, буферизовать событие, не потерять очередь. Эти вещи несложно собрать в n8n, если заранее заложить ветви для ошибок и хранение последних попыток. Я заметила, что когда метрики есть в виде понятных чисел, эксперименты становятся спокойнее, а конфликты между командами исчезают.
Чтобы не спорить словами, я иногда показываю визуальную выкладку про типы алертов и точки контроля. Она помогает быстро понять, где фильтры слабы, а где наоборот переусердствовали, и почему это сказывается на восприятии шума.
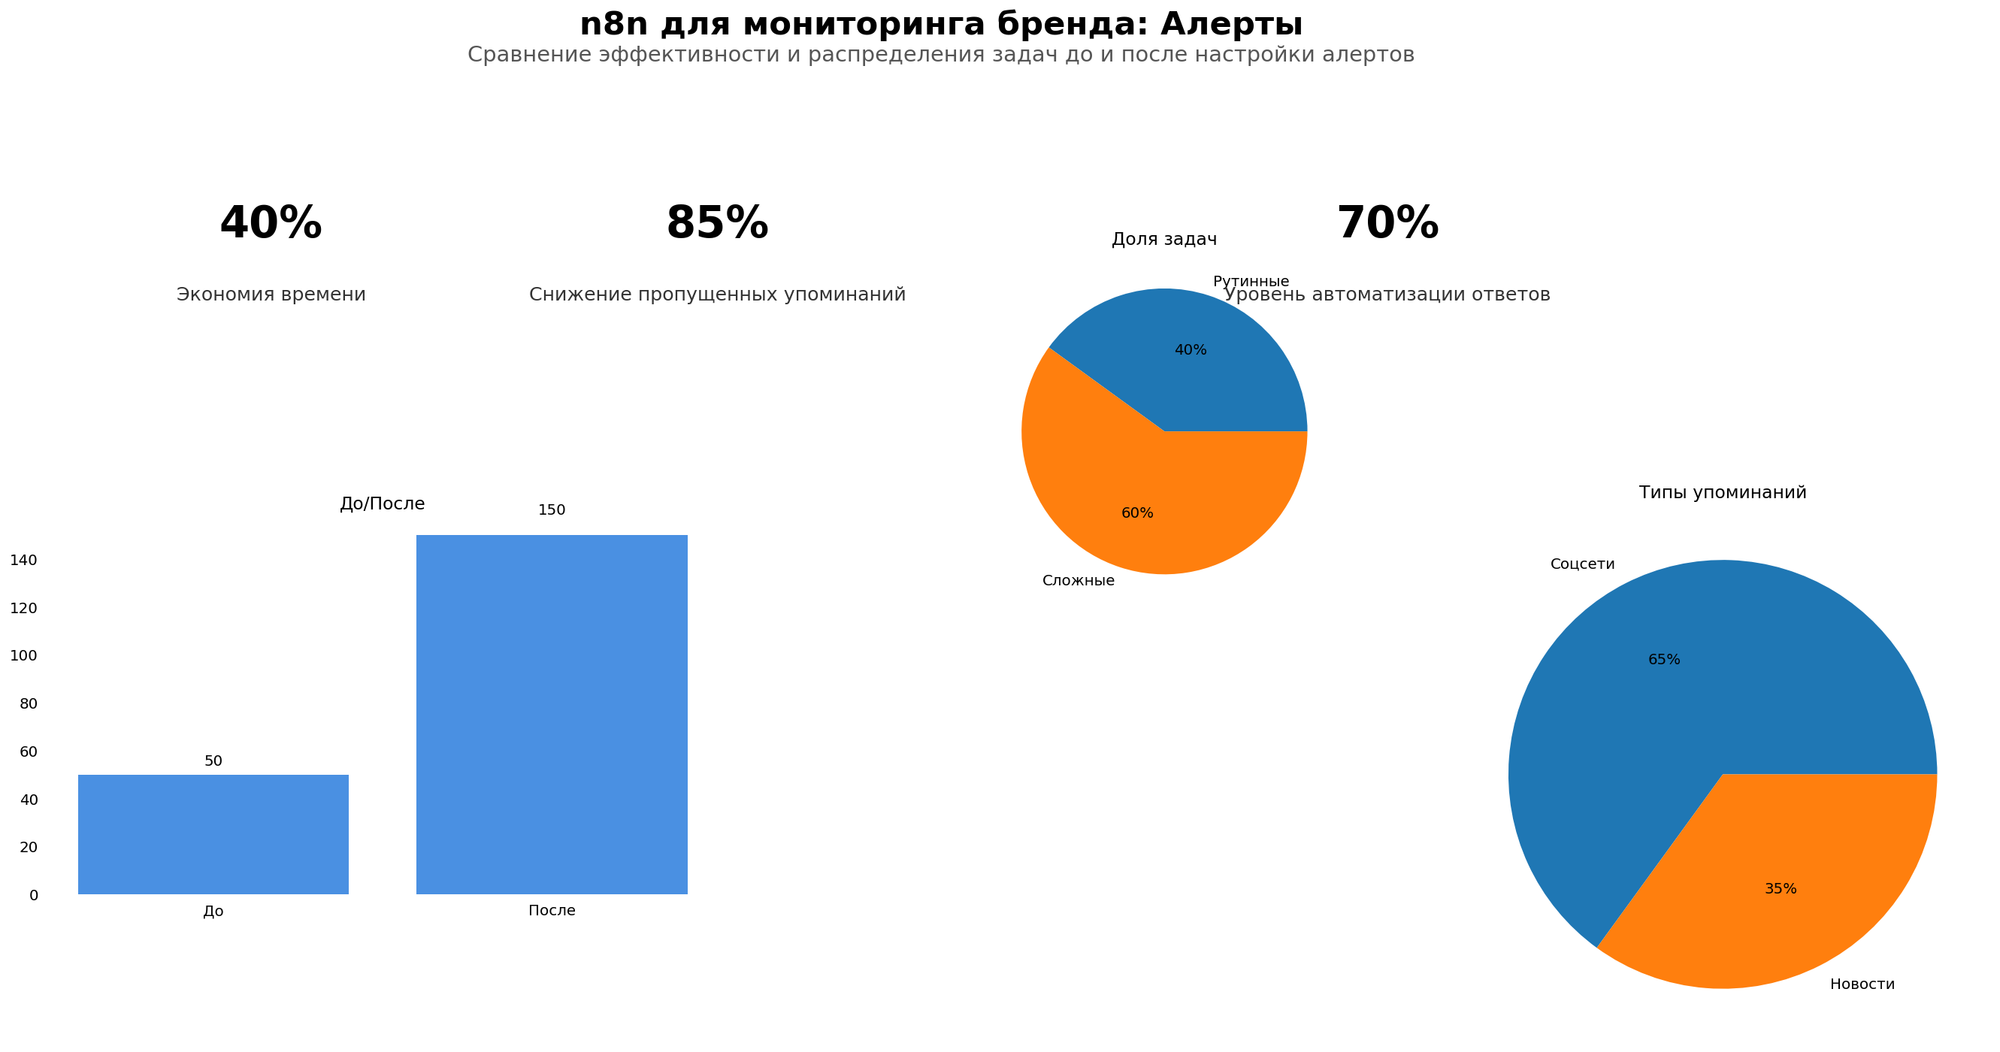
И да, есть мысль, которую я повторяю себе, когда хочется «ускорить любой ценой» и закрутить частоту опроса. Это простой якорь для здравого смысла, работает лучше, чем будильник. Скорость без смысла - это шум, а шум - это усталость, которая отключает внимание. Гораздо выгоднее потратить полчаса на фильтр, чем неделями разучиваться игнорировать уведомления.
Что и как логировать, чтобы потом не искать иголку
В моих проектах есть минимальный набор логов: входящее событие с маскированными полями, ветка принятого решения, результат отправки алерта, код ошибки и повтор. Логи лежат отдельно от самой истории процесса, чтобы их можно было анализировать независимо и не бояться кластеризации по задачам. Для быстрых разборов делаю выборки: какой триггер дал большинство шумных сигналов, где чаще всего падал ретрай, какие условия фильтра чаще всего срабатывали. Это помогает не гадать, а видеть, где болит, и какие 20% усилий дадут 80% эффекта. Для аудита я фиксирую политику хранения логов и сроки - чтобы не тащить вечность, но и иметь возможность расследования. И да, было дело, однажды я два часа искала пропавший алерт, пока не увидела, что лог-файл на тесте перезаписывается слишком часто - после этого добавила ротацию и успокоилась.
Лог - это не «черный ящик», это дневник решений. Если он не отвечает на вопрос «почему система повела себя так», значит, его надо переписать.
Как тестировать и накатывать изменения без нервов
Я держу три окружения: песочницу для экспериментов, стенд для интеграции и прод, и стараюсь не смешивать эти миры даже в мелочах. Для сложных фильтров пишу пару тестовых историй руками и прогоняю через ноды, чтобы убедиться, что не поймала боковой эффект. В n8n удобно сохранять версии workflow и откатываться - я этим пользуюсь и отмечаю комментарием, что меняла и зачем. Перед релизом включаю тихий режим: алерты уходят в отдельный канал, где дежурит один ответственный и ловит странности. Если через два дня все спокойно, значит, можно включать на всех и спать без четвертого кофе. И да, когда рука тянется «сделать за пять минут на проде», я вспоминаю, сколько потом это «пять минут» стоило ночью, и закрываю вкладку.
Где чаще всего ломается и как обезопасить процесс?
Самые частые провалы я видела в трех местах: хаотичные триггеры, отсутствие дедупликации и слишком широкий доступ к данным. Хаотичные триггеры рождают лавину ложных алертов и отучают команду реагировать, отсутствие дедупликации превращает одно событие в многоголосый хор, а широкий доступ к ПДн - это не только риск штрафа, но и внутреннее напряжение. Я научилась крутить эти три ручки заранее и проводить короткий «предрелиз» с тихими каналами, где ловлю шум. Еще один слабый узел - отсутствие владельца: когда непонятно, кто отвечает за источник и ключи, проблемы становятся бесконечными, потому что «это не ко мне». И да, иногда ломается интеграция с внешним сервисом, и workflow должен уметь замолчать и подождать, а не бомбардировать всех ошибками каждые две минуты. Это признак зрелости системы, а не «лени» разработчика.
Наглядно конфликт «шум против покрытия» хорошо виден на сравнительных инфографиках о том, что именно мы мониторим и чем. Я добавляю схему, чтобы взглядом почувствовать баланс и обсудить, где уместно резать, а где лучше расширять.
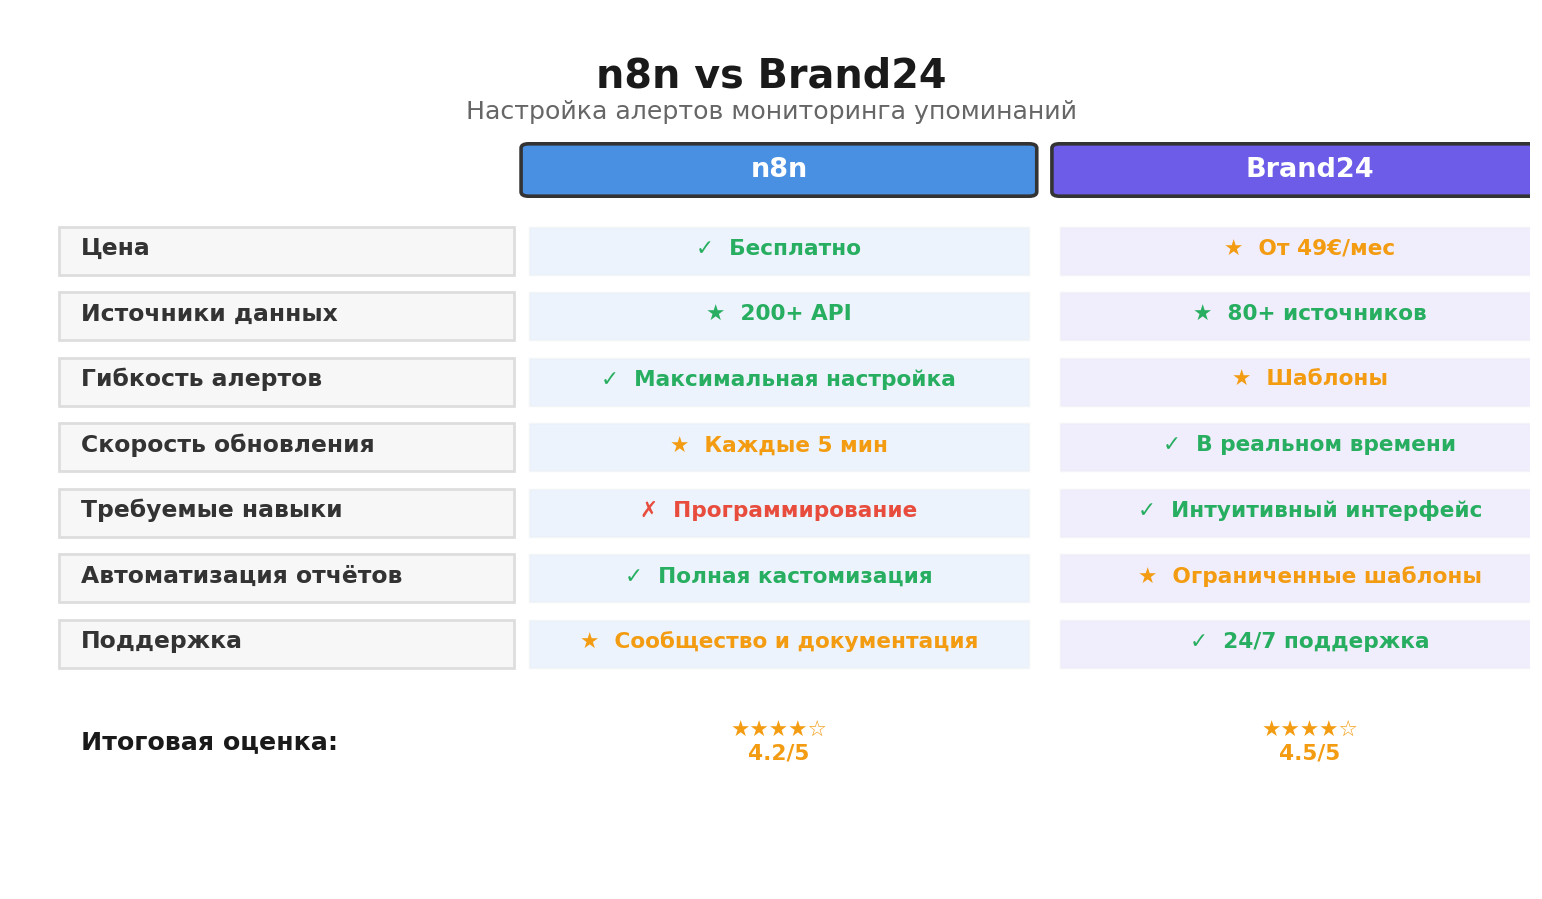
И маркирую одну мысль, которой часто не хватает в регламентах. Она про границы охоты за «идеальным покрытием» и цену ошибок внимания. Не бывает нулевого шума и полного покрытия одновременно - выбирайте осознанно и фиксируйте пороги. Это уменьшает споры и дает команде право сказать «хватит» раньше, чем люди выгорят.
Типовые ошибки и как я их ловлю на ранней стадии
Когда накопилось достаточно кейсов, я вытащила типичные промахи и завела для них короткие проверки. Это не бюрократия, а способ сохранить нервы, особенно в пятницу вечером, когда всё почему-то ломается. Я оставляю их здесь как блок заметок - они простые и понятные, и да, я сама иногда на них попадаюсь. Перед запуском на проде я пробегаю глазами и честно ставлю галочки, потому что память - вещь коварная. Если хотя бы один пункт дал сбой, релиз уезжает на следующий слот - проверено опытом, лучше так, чем героизм ночью.
- Правило: у каждого триггера есть владелец и расписание, нет дублей по каналам.
- Правило: фильтры читаемые словами процесса, а не только выражениями.
- Правило: дедупликация по окнам времени настроена, ключ уникальности согласован.
- Правило: каналы развязаны по приоритетам, критика не смешана с отчетами.
- Правило: ПДн замаскированы в алертах, в логах нет идентификаторов.
- Правило: есть тихий режим и ротация логов, ретраи не забивают очередь.
ПДн и белые данные: границы и здравый смысл
Я выстраиваю простую границу: алерты не содержат ПДн, даже если очень хочется видеть имя и телефон, а ссылки ведут в защищенную систему, где уже работают права доступа. Белые данные - это публичные упоминания, обезличенные агрегаты и техническая телеметрия, с которой можно работать без риска. Если нужно подключать ИИ-агента, он получает только то, что необходимо для задачи, и ничего «на память», если только не настроена отдельная песочница и документированная n8n настройка агента с хранением в zep.
Соблюдать 152-ФЗ приятно, когда это встроено в процесс, а не навешано сверху. Тогда контроль не мешает скорости, а ускоряет ее, потому что меньше пожаров.
Я уже не вспоминаю, когда в последний раз спорила с безопасниками: когда есть прозрачные правила и логи, споров почти не остается, и команда спокойно делает работу.
Я люблю тихие развязки, поэтому завершу простой сценой. После двух недель с новым мониторингом я поймала себя на том, что перестала вскакивать от уведомлений, а уведомления стали поводом к понятному действию, а не к панике. Это означает, что система вошла в рабочий ритм: триггеры бьют редко и по делу, фильтры держат шум в пределах оговоренного, а логи отвечают на вопрос «почему». В цифрах это выглядело так: на 27% меньше сообщений, на 35% быстрее первая реакция и ноль пропущенных критичных событий за неделю. Еще заметила приятное: команде стало легче принимать решения, потому что у каждого алерта появился контекст и ссылка на источник, а не поток загадочных сообщений в чате. И да, кофе перестал остывать в попытках понять, что случилось - я стала чаще допивать чашку до конца, а это уже маленький маркер здоровья процесса. Получается, что рецепт работает: цель, триггеры, фильтры, каналы, логи - без магии, но с уважением к времени и к людям, которые это поддерживают.
Если хочется структурировать эти знания и разложить под свои кейсы, можно посмотреть мои разборы и схемы - я аккуратно собираю их на сайте и в спокойном канале. Для практики под российские реалии и белые данные у меня есть подборка материалов, где n8n настройка, телегам n8n настройки и примеры с ИИ-агентами собраны в одном месте. Можешь без спешки присоединиться к моему каналу MAREN: автоматизация и ИИ-практики и почитать кейсы, а на сайте promaren.ru лежит разметка по темам - кому нужна системность, тот оценит. Никакой агрессии и «бегом сюда» - просто пространство, где мы вместе учим процессы делать работу за нас, а время возвращаем себе.
Что ещё важно знать
Как часто опрашивать источник, чтобы не утонуть в шуме и не пропустить инцидент?
Я начинаю с минимально достаточной частоты и проверяю долю пустых алертов. Если шум высок, увеличиваю окно или добавляю дополнительное условие. Для критики ставлю вебхуки, для аналитики - расписание с агрегированием.
Можно ли хранить логи алертов в облаке и не нарушить 152-ФЗ?
Если логи содержат ПДн или позволяют идентифицировать человека, храню их в РФ и маскирую поля. В облако могу выводить агрегированные метрики и технические статусы без персональных атрибутов. Это снижает риски и упрощает аудит.
Что делать, если алертов стало слишком много и команда перестала реагировать?
Включаю тихий режим на пару дней, считаю долю пустых сигналов и смотрю, какие фильтры срабатывают чаще. Чаще всего помогает дедупликация по окну времени и перенос части уведомлений в отчеты. Разграничиваю каналы по приоритетам.
Как настроить интеграцию с Telegram, чтобы не было утечек?
Выношу ПДн из текста, оставляю ссылки в защищенный контур, ограничиваю доступ к каналам. Включаю аудит входов и разграничиваю роли. Для критичных событий делаю отдельный канал и короткий формат сообщений без лишних полей.
Можно ли подключить ИИ-агента, чтобы он фильтровал или классифицировал события?
Да, но даю ему только необходимые данные и фиксирую границы. Память агента храню отдельно и документирую, например через zep, если это действительно нужно. И всегда оставляю логи решений, чтобы понимать, почему он выставил метку.
Что выбрать для быстрых таблиц и отчетов, если данные обезличены?
Для быстрых рабочих витрин подходит Airtable, и нода в n8n настраивается просто. Если появляются персональные поля, переношу в локальную базу и ограничиваю доступ. Так проще соблюсти закон и не усложнять себе жизнь.
Как понять, что система мониторинга настроена «по‑взрослому»?
Есть владелец у триггера, фильтры читаются словами процесса, каналы развязаны по приоритетам, логирование отвечает на вопрос «почему». Метрики реакции видны, доля пустых алертов контролируется, а изменения раскатываются через тестовый контур.
Автоматизация воронок продаж
Лид от комментария до оплаты без ручного менеджера, запуск за 10–14 дней

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


