
Я знаю, зачем ты здесь: n8n мониторинг хочется настроить быстро, прозрачно и по правилам, чтобы алерты приходили вовремя, а Роскомнадзор не звонил по утрам. Я в России, работаю в белой зоне с акцентом на 152-ФЗ и локализацию, поэтому покажу, как собрать рабочую схему без лишней магии. В этом материале я, Марина Погодина, разложу мониторинг упоминаний бренда на понятные шаги и покажу, как n8n и аккуратная архитектура помогают сэкономить часы, не рискуя персональными данными. Мы пройдёмся по источникам, фильтрам, алертам и хранению, добавим немного быта вроде того, как n8n запустился лишь с третьей попытки, и как кофе успел остыть. Это инструкция для российских специалистов по автоматизации, маркетологов, аналитиков и тех, кто строит свои процессы на Make.com, n8n и ИИ-агентах. Я дам практические детали без продаж и хайпа, аккуратно вплету нюансы white-data-подхода и дам ссылки на полезные материалы. Получится связная цепочка, после которой мониторинг начнёт работать как часы и не будет съедать ваши выходные.
Иногда мне кажется, что самые громкие репутационные истории начинаются не с хейта в соцсетях, а с тишины в оповещениях. Когда замечаешь негатив через сутки, уже приходится тушить пожар, а не аккуратно погасить искру. На российских проектах это ощущается сильнее, потому что тройная проверка по 152-ФЗ, локализация и учёт согласий добавляют слоёв к простой, казалось бы, задаче. Я люблю, когда процессы честны, а метрики прозрачны, поэтому мониторинг упоминаний для меня - это не про хайп, а про дисциплину и инфраструктуру. Если сделать основу правильно, потом всё крутится само: парсер вытянул упоминание, фильтр отсёк мусор, n8n отправил алерт, человек принял решение. Я работаю так дома и в командных процессах, на локальных серверах и в облаках РФ, и вижу, как время отклика сокращается до минут, а не часов. В этом тексте я собрала свой подход и разметила дорожку, чтобы любой специалист прошёл её без пробежки через грабли. Кофе остынет, но мониторинг будет стабилен - проверено ночными релизами.
Что мешает мониторингу упоминаний в России и почему сейчас особенно
Если коротко, нас ограничивает не технология, а контур ответственности: локализация, отдельные согласия, минимизация и запреты на автоматические юридически значимые решения. Я каждый раз повторяю эту мантру перед стартом проекта, потому что мониторинг влечёт обработку комментариев и профилей, а значит легко задеть персональные данные. С 2025 года правила ужесточились, поэтому складывать упоминания на зарубежные сервисы - плохая идея, а парсить без фильтров и обезличивания - рискованная. На практике я закладываю российские дата-центры и белые API, включаю маскирование ПДн до алерта и храню только критичное: ссылку, контекст, время, оценку тональности. Это критично, потому что минимизация данных напрямую уменьшает риски, а ещё упрощает аудит и снижает время разбора инцидентов. Да, звучит скучно, но именно тут экономится львиная доля часов: меньше споров с безопасностью и меньше переделок после проверок. Получается, что хороший мониторинг строится как бухгалтерия - всё разложено, у каждого шага есть регламент и логи.
Когда люди говорят, что мониторинг - это кнопка, я улыбаюсь и добавляю: кнопка работает только в системе, где учтены право, хранение и роли, иначе это просто красивая иллюзия.
Пару бытовых штрихов. Я не раз ловила ситуацию, когда в Telegram прилетает алерт с фамилией, телефоном и кусочком переписки - и рука тянется переслать его коллеге. Стоп, так не пойдёт: в моих пайплайнах такие поля маскируются по умолчанию, а подробности раскрываются только в частном контуре для ответственного сотрудника. Это означает, что мы изначально проектируем многослойный доступ, а не надеемся на «авось». На российском проекте это особенно чувствуется: при проверке Роскомнадзора вопросы всегда про процессы, а не про цвет кнопки в интерфейсе. Поэтому я заранее готовлю документы: цели обработки, базу прав, сроки хранения, порядок удаления по запросу субъекта. Документы скучны, но без них автоматика становится слабым звеном. Здесь n8n помогает собрать всю логику в одном месте, а затем увязать её с журналами и маршрутами согласования.
В качестве визуальной опоры покажу базовую схему потока, который мы будем собирать в статье. Картинка помогает держать в голове ритм движения данных и точки контроля.
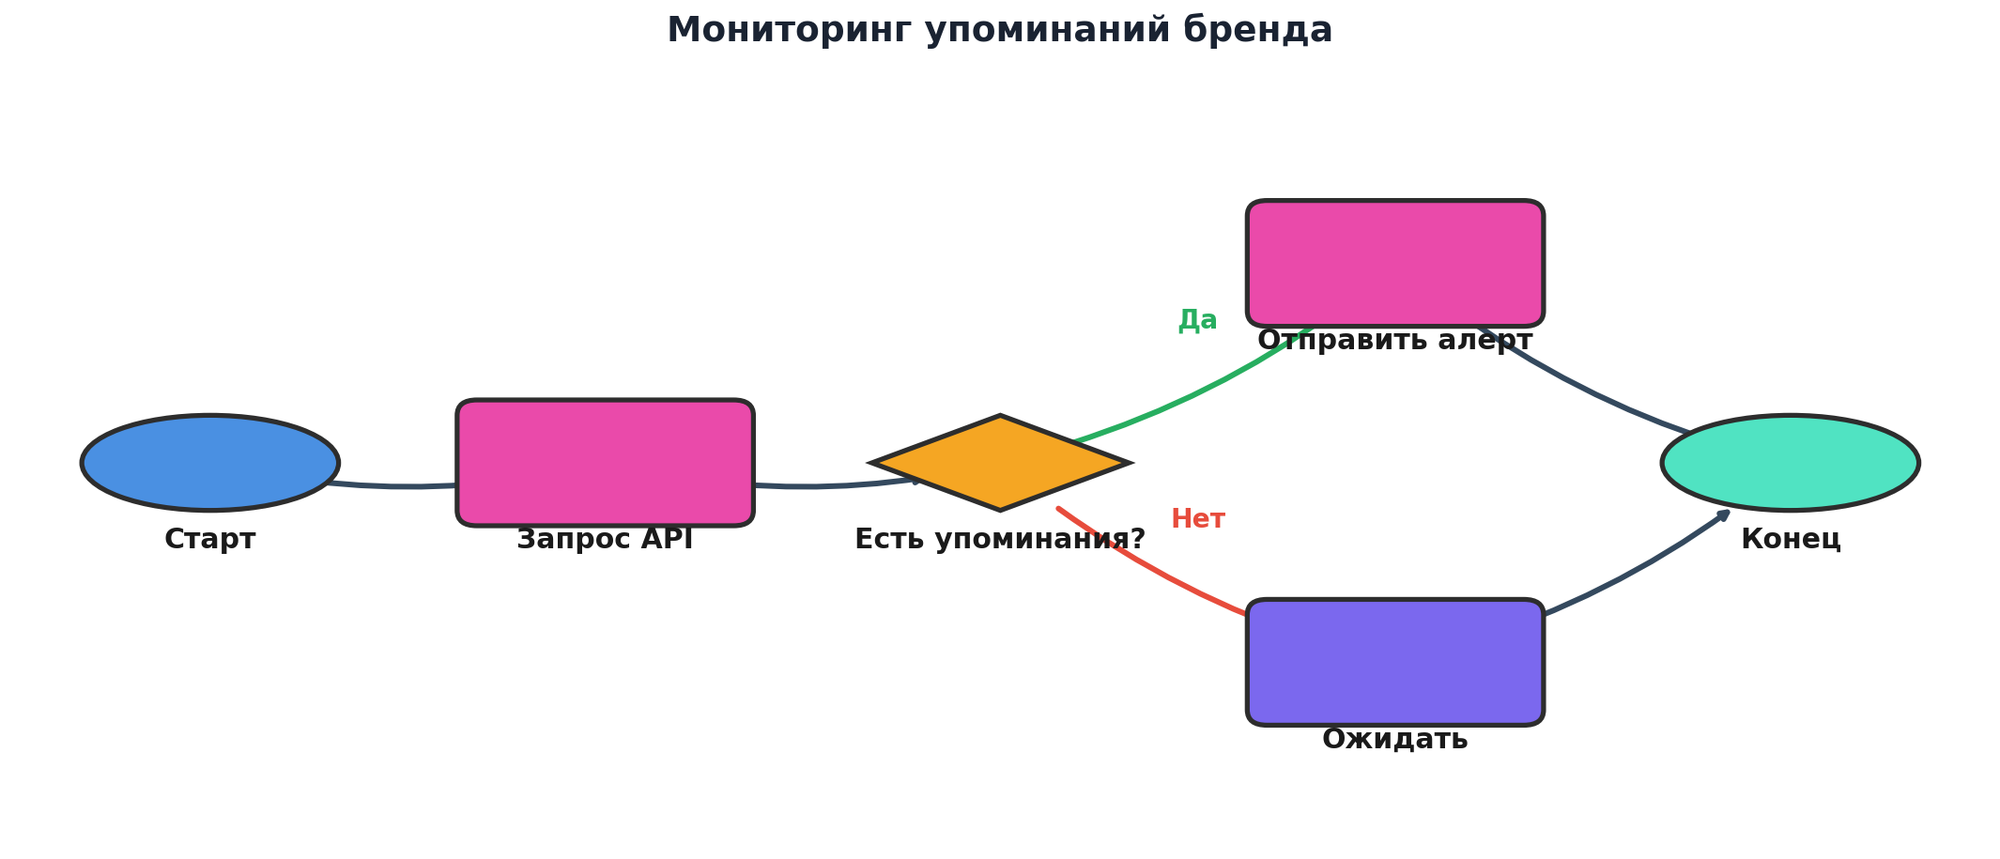
На практике это означает простое: мы ограничиваемся данными, необходимыми для реакции, и проектируем выходы для юридически значимых шагов. Я заметила, что когда команда видит поток на одной схеме, спорить проще и быстрее - каждый знает, где начинается его зона ответственности. И ещё одно наблюдение: чем раньше подключишь безопасность и юристов, тем быстрее поедет автоматика. Да, иногда это отнимет пару часов в начале, зато несколько месяцев потом ты не будешь ничего латать. В результате проблемный блок становился устойчивым, а время реакции на упоминания падало до пяти минут - даже при высокой нагрузке в новости и VK. Так мы плавно переходим к решению на базе n8n.
Как n8n решает задачу мониторинга и укладывается в 152-ФЗ
Если нужен управляемый конструктор с прозрачной логикой, n8n оказывается удобным выбором: локальная установка, гибкие узлы, токены, маршруты и человеческий визуальный редактор. Я работаю с ним как с оркестратором: n8n собирает упоминания из источников, фильтрует, минимизирует ПДн, отправляет алерты и пишет логи. Важный момент для РФ - разворачиваем в российских дата-центрах и не допускаем трансграничную передачу ПДн без обоснования. Секрет устойчивости прост: хранить меньше, чем хочется, и документировать больше, чем кажется нужным. Это звучит чуть иронично, но после первой аудиторской сессии у команды исчезают лишние поля из алертов, а у меня - меньше поводов волноваться ночью. Я добавляю шаги для маскирования и хэширования, делаю приватные ветки для данных с повышенной чувствительностью и оставляю короткие алерты в Telegram. Это удобно и честно.
Мне важно проговаривать, что n8n - не волшебная палочка, а инструмент, который дисциплинирует архитектуру и учит считать последствия каждого поля и каждого запроса.По ходу настроек часто всплывает сравнение с другими платформами. На российских проектах я чаще дополняю n8n локальными сервисами и базами, а не заменяю его, потому что роль оркестратора внятна и стабильна. Если добавить к нему понятный регламент и описать роли, получается та самая «мозговая» автоматика, где человек остаётся в контуре принятия решений. Вот на такой схеме сравнения видно, почему в моих задачах n8n выигрывает гибкостью и контролем развертывания в РФ.
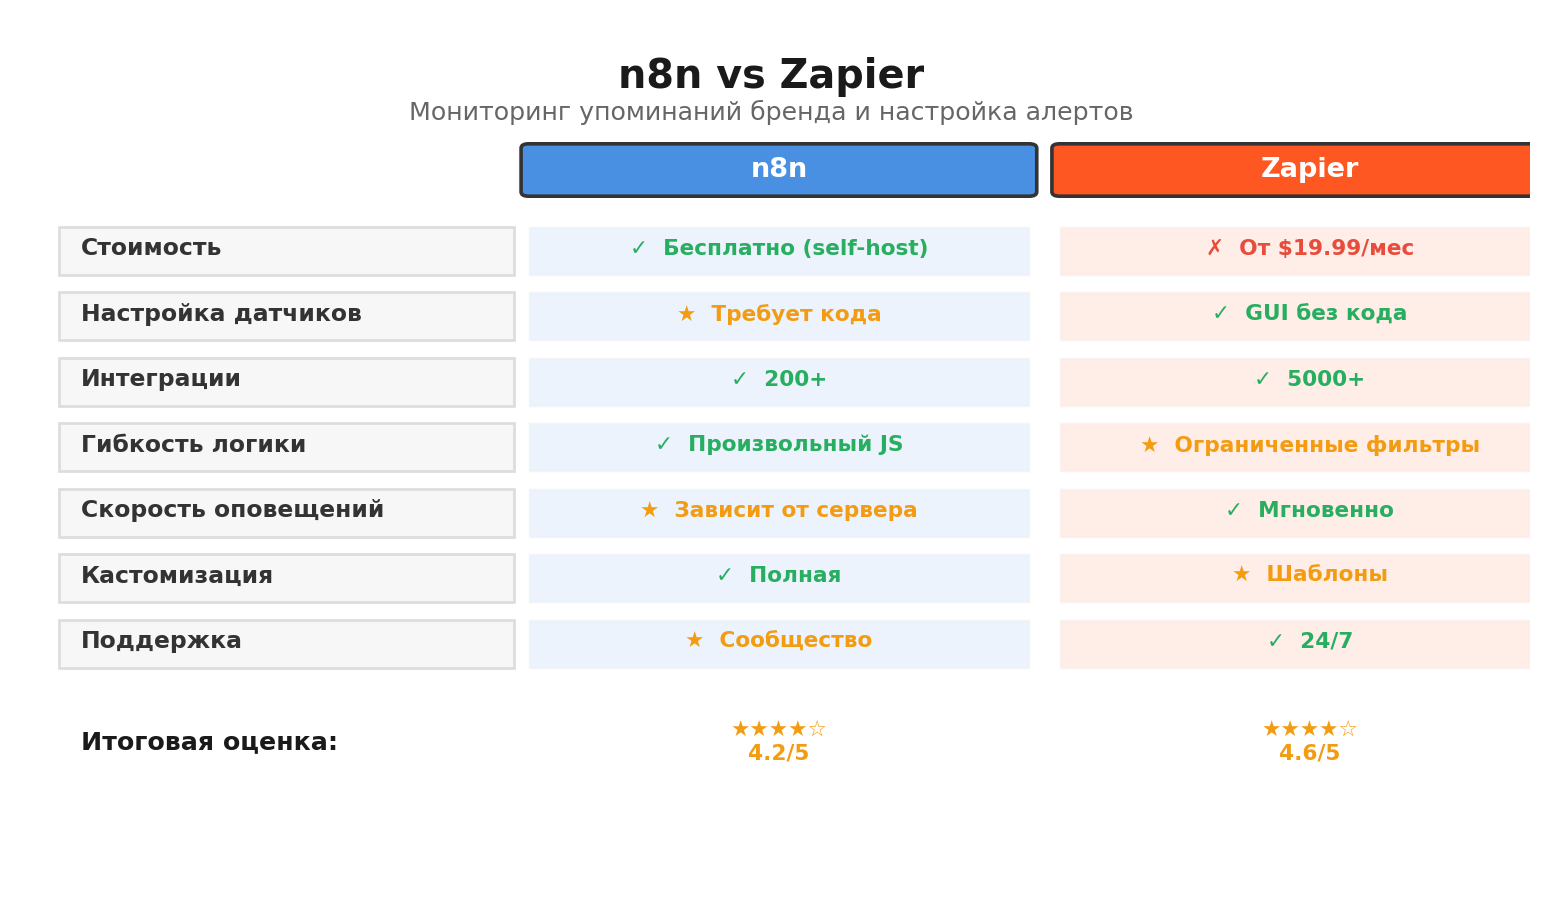
Я заметила, что вопросы по n8n настройка агента возникают всё чаще, особенно когда подключают ИИ для классификации тональности и приоритизации. Здесь важно не путать удобство с безопасностью: агент может обучаться на обезличенных примерах и работать внутри периметра, а не уносить контекст наружу. Если нужен долговременный контекст, обсуждаем n8n настройка zep и аналогичные локальные варианты для памяти агента, но строго без ПДн в чистом виде. В итоге решение получается гибким и масштабируемым, а правовая часть не страдает. Это означает, что мы можем автоматизировать 70-80 процентов цепочки и оставить на человеке мягкую финальную валидацию.
Какие инструменты и интеграции понадобятся для российского стека
Когда я впервые собираю стек, начинаю с источников: VK, Дзен, YouTube, профильные сайты и публичные отзывы. Дальше беру парсеры, которые не лезут туда, где нельзя по правилам площадок, и проверяю юридические риски. Для хранения - российские облака, например Яндекс.Облако или Selectel, и локальная СУБД, где журналы аудита и настроенные сроки жизни записей. В n8n я подключаю узлы запросов к API, ветвления, обработку текста, шифрование и отправку в Telegram. Если нужен каталог инцидентов, завожу компактную таблицу в локальной базе, а если проект не содержит ПДн - подойдёт и облегчённый контур, где хранится только URL и оценка тональности. Здесь работает принцип минимизации: не храним поля ради красоты, оставляем только рабочие.
Белая интеграция побеждает всегда: официальные API, локальные хранилища, понятные роли и аккуратные журналы. Это скучно, зато спишь спокойно и планы не рушатся от одного письма с проверкой.
Про интересные узлы. Запросы к VK API и YouTube API закрывают большую часть публичных упоминаний, а для сайтов отлично подходят расписания с парсером по RSS или аккуратным парсингом HTML в рамках правил. По n8n tool настройка я обычно оставляю шпаргалку с переменными окружения для токенов и с отдельными путями логирования, чтобы команда не путалась. Если приходится работать с таблицами для трекинга, можно подключать AirTable - только убедитесь, что не тянете туда ПДн без локализации, иначе лучше держать аналоги в РФ. Когда меня спрашивают про настройка ноды airtable в n8n, я уточняю задачу: если это чисто технические метаданные, живём спокойно, если контакты - останавливаемся и переносим в локальную БД. Получается стек, где каждый узел знает свою роль и не пытается быть всем сразу.
Чтобы закрепить набор компонентов, покажу схему интеграций, которая помогает объяснить команде движение событий и границы ответственности. Дальше мы углубимся в 5 шагов настройки.
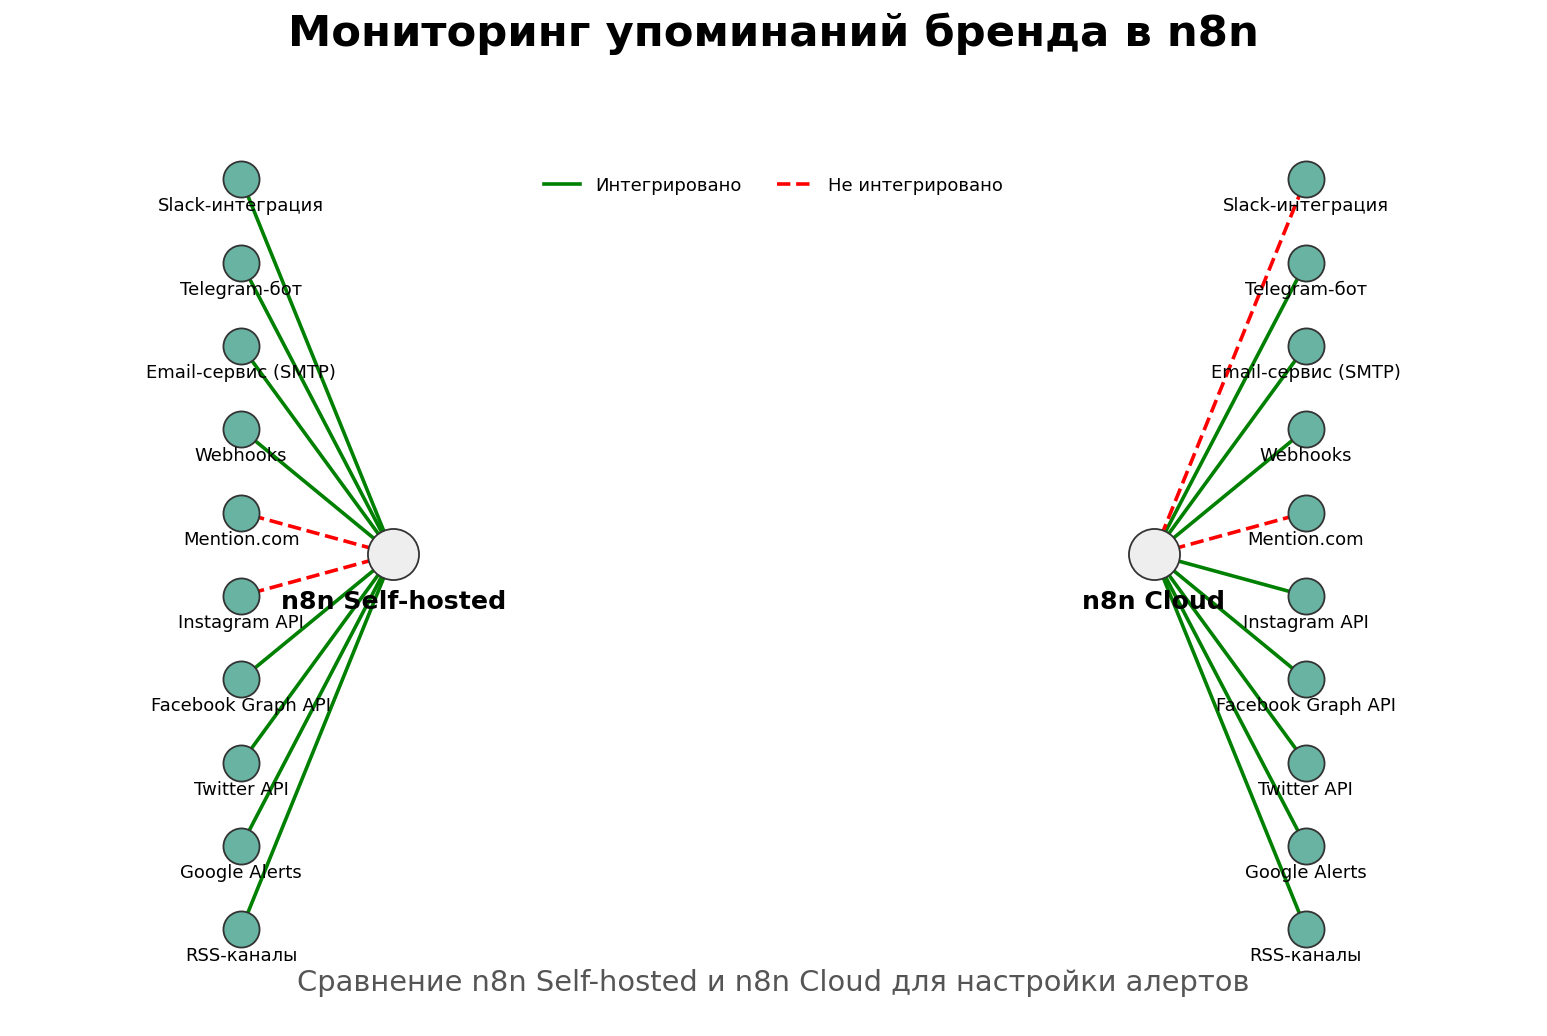
Я аккуратно оформляю документацию и прикладываю её рядом с воркфлоу: где хранятся логи, кто отвечает за удаление по запросу, какой SLA на реакцию. В рабочем ритме это избавляет от бесконечных вопросов, потому что всё на месте и понятно. Ещё один нюанс: иногда команда хочет «всё и сразу» - ловить любые упоминания, собирать глубокие профили и делать автодействия. Я мягко возвращаю к сути: сначала правовая база и быстрая реакция, потом усложнения. Это сохраняет скорость и снижает риски. Кстати, в основной части статьи будет ссылка на автоматизацию через n8n на моём сайте - её можно сохранить в закладки и вернуться, когда будете собирать свой первый поток.
Если хочется отдельного развернутого гайда с примерами, я держу материалы в своей экосистеме: разборы кейсов, карты маршрутов и подборки узлов. Для старта хватит того, что ниже, а дальше уже можно углубляться и адаптировать под свою отрасль и масштабы.
Как настроить алерты в n8n за 5 шагов
Сейчас покажу прямую дорожку: 5 шагов, которая повторяется из проекта в проект и экономит часы. Я специально разверну каждый шаг коротко и понятно - без лишней воды и с проверками на ПДн. После первого запуска вы уже увидите алерты, а после доводки сэкономите десятки кликов в день. Ниже использую нумерацию браузера, а не ручные цифры.
- Подключите источники: VK, Дзен, YouTube, новости. Проверьте условия API и цели обработки.
- Добавьте фильтры по ключевым словам, языку и площадке. Маскируйте потенциальные ПДн.
- Обработайте данные: нормализуйте текст, оцените тональность, удалите лишнее.
- Соберите алерты: Telegram, почта, внутренняя CRM. Минимизируйте содержимое.
- Настройте хранение и логи в РФ, пропишите роли и сроки удаления.
Я заметила, что основной выигрыш в качестве даёт именно маскирование перед отправкой в Telegram - моментально отпадает риск пересылки лишнего. В итоговой картинке удобно увидеть цепочку подряд, чтобы не потерять место, где мы минимизируем данные и где переходим к алертам.
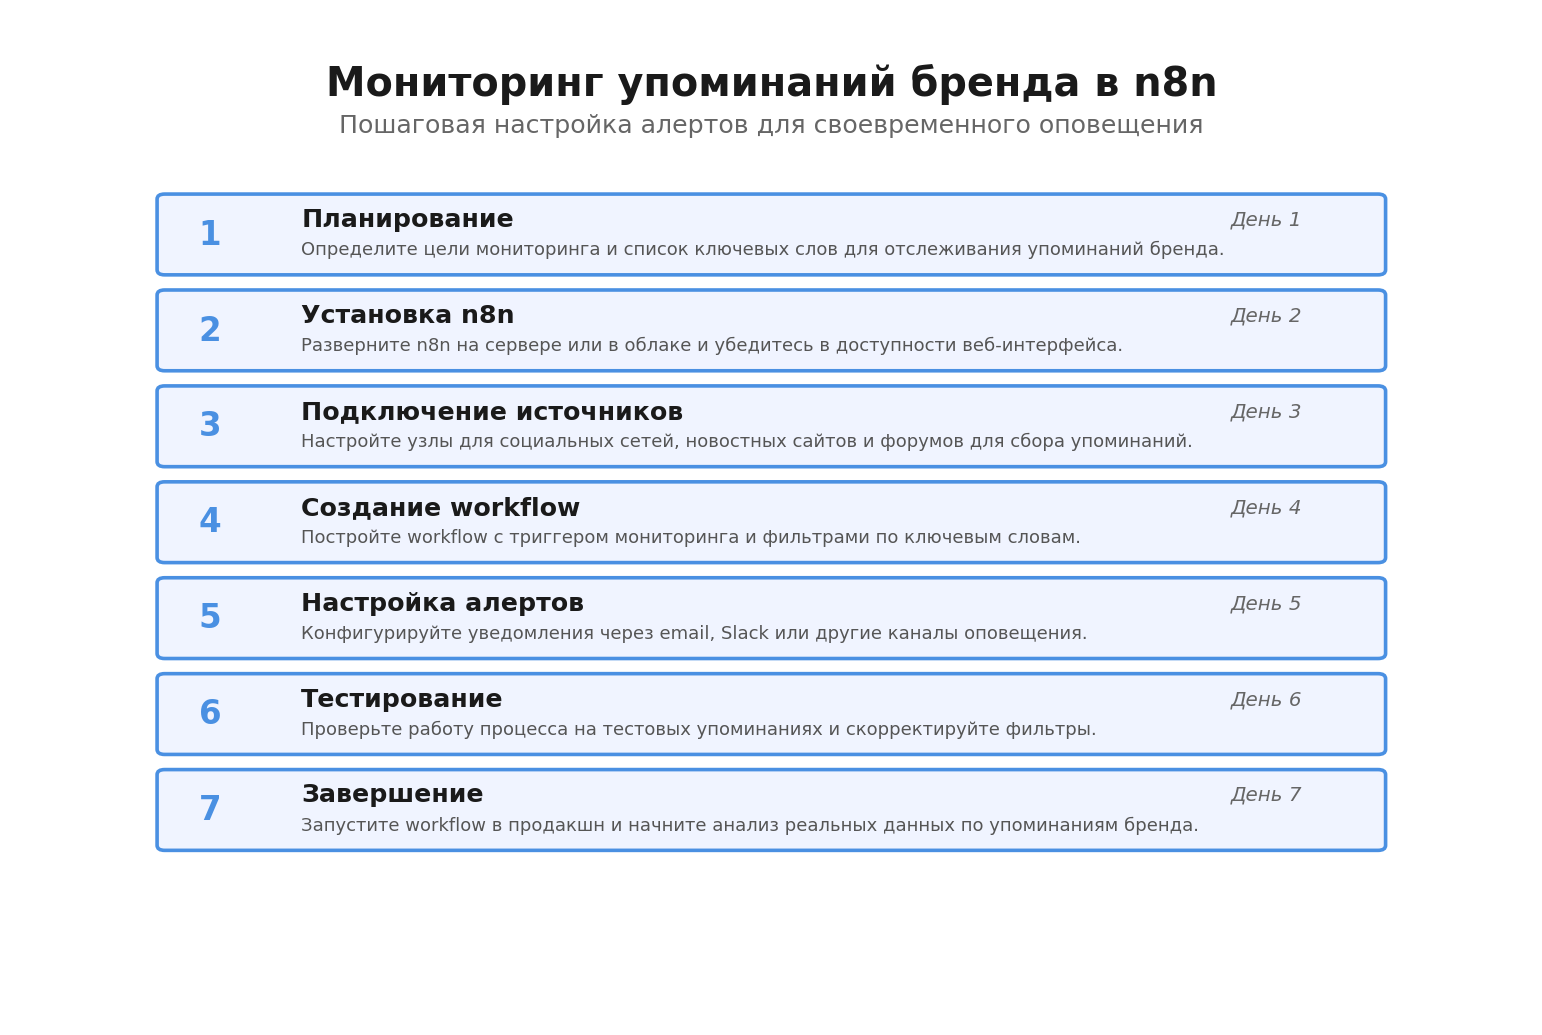
Есть мелкие технические шаги, которые экономят время. Я делаю переменные окружения для токенов, добавляю проверку «тишины» потока, чтобы не спамить, и ставлю расписание так, чтобы попадать в пики обсуждений. На практике это снижает ложные тревоги и стабилизирует поток. Если просили «телегам n8n настройки», всегда уточняю контекст: речь о боте, канале, приватности или о маршрутизации. Это означает, что один и тот же инструмент решает разные задачи, и только правильная постановка даёт нужный результат. После недели эксплуатации обычно видно, где узкое место, и мы подкручиваем частоту, фильтры или формат алертов. В итоге цепочка становится предсказуемой, как утренний будильник, который, увы, не пропускаешь.
Чтобы взглянуть на альтернативное представление процесса, добавлю инфографику с акцентом на «где что происходит» - удобно для обсуждения с командой. Картинка помогает согласовать роли и точки интеграции.
Как обезличивать и при этом не терять смысл
Я делаю маскировку полей прямо перед алертом, чтобы риск пересылки чувствительных данных равнялся нулю, а смысл сообщения оставался читаемым. Сначала мы вырезаем номера, email, явные ФИО и никнеймы по регулярным выражениям, затем применяем словарь замены на типовые шаблоны и оставляем ссылку на источник и ключевую цитату контекста. Так алерт остаётся информативным, но не содержит лишнего, а подробности смотрит ответственный в закрытом контуре. Если команда переживает за контекст, можно расширить выдержку, но всё равно лучше не переносить туда ПДн. На практике это снижает риски и снимает барьеры на пути к быстрой реакции, потому что никто не боится переслать сообщение руководителю или коллеге. Это означает, что мы ускоряем коммуникацию за счёт грамотной минимизации.
Как вписать ИИ-агента и не нарушить правила
Я подключаю агента для классификации тональности и приоритизации, но всегда держу его в периметре и на обезличенных данных. Обычно это n8n настройка агента с локальной моделью или приватным API, где память хранится на своей стороне - если нужно, через n8n настройка zep или аналогию. Агент не должен принимать юридически значимые решения, поэтому ставлю ручную валидацию на шаге, где возможны последствия. В итоге у нас появляется умная подсказка и сортировка очереди, но человек остаётся последним звеном, которое подтверждает действие. Я заметила, что такая схема даёт большую экономию времени и не вызывает споров у юристов. Получается мягкий баланс между скоростью и безопасностью.
Какие результаты вы получите и какие метрики смотреть
Первое, что почувствуете, - снижение шумовой нагрузки: в алертах только нужный контекст, без лирики и лишних полей. Второе - ускорение принятия решений за счёт приоритизации и понятных каналов. Третье - упрощение аудита, потому что логи аккуратные и живут в РФ. Я люблю, когда метрики не спорят друг с другом: время до алерта, время до реакции, доля ложноположительных и охват источников дают цельную картину. Если эти четыре линии смотрят в одну сторону, всё едет в правильном направлении. Иногда спустя пару недель замечаешь, что команда уже не возвращается к ручному мониторингу - просто нет смысла. В цифрах это часто минус 60-70 процентов ручной работы и плюс несколько очков к репутационной устойчивости, что видно на графиках отклика.
Парадокс автоматизации в том, что по-настоящему экономит она тогда, когда вы смотрите на метрики регулярно, а не от отчёта к отчёту. Иначе все выигрыши испаряются в рутине.
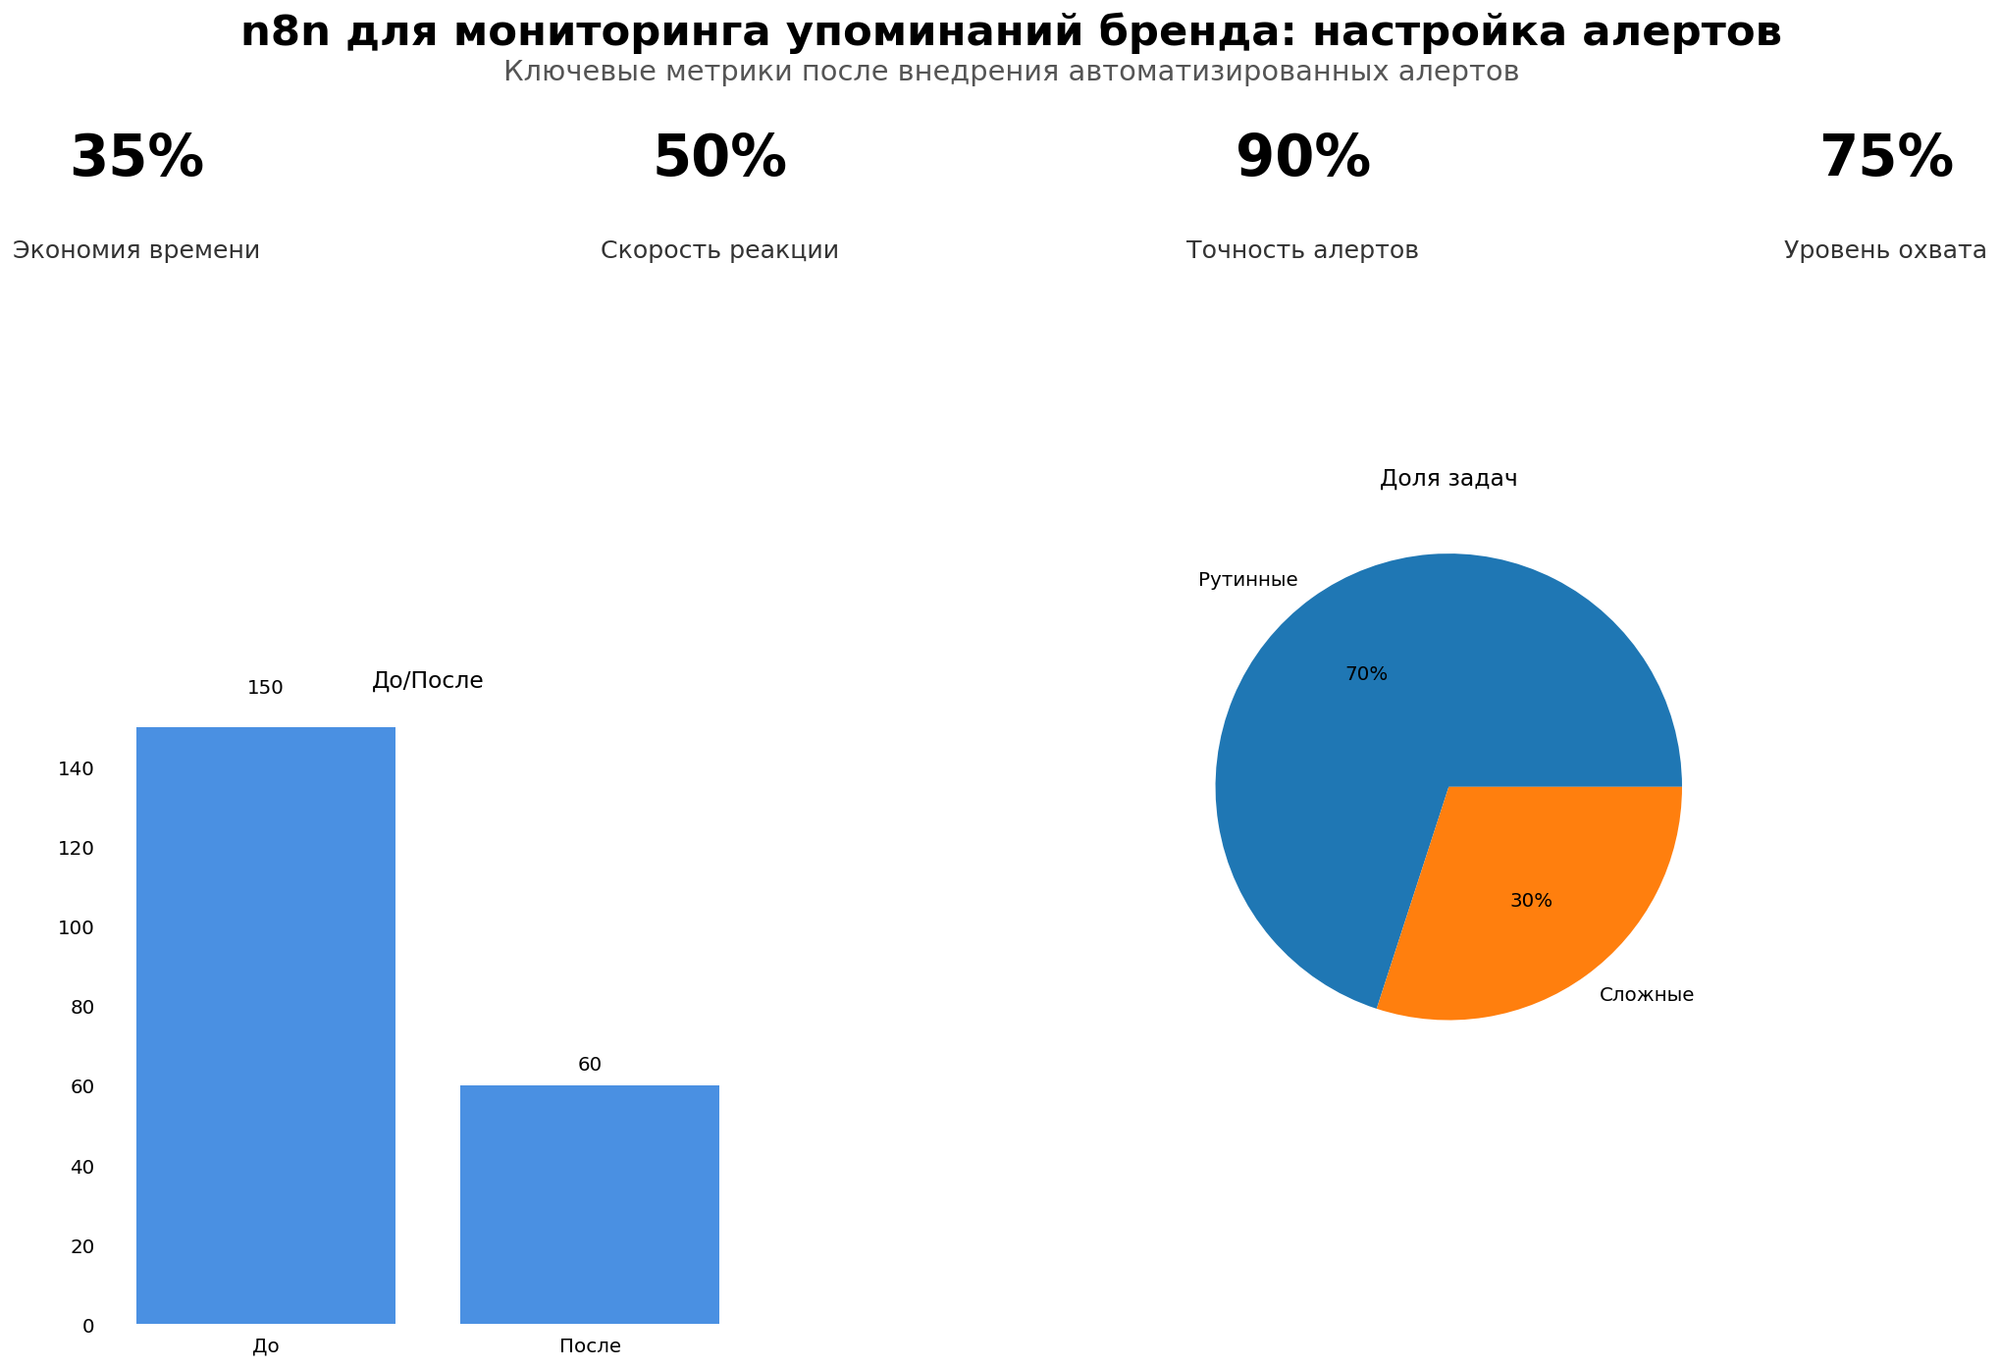
Я заметила полезную практику - договориться о ключевых порогах до старта, чтобы потом не спорить, хороший это результат или «недотянули». В реальности между каналами есть перекосы: VK шумнее, YouTube медленнее, новостные сайты стабильнее по формату. Это означает, что пороги лучше задавать на канал и на тип события, а не пытаться усреднить всё сразу. Ещё хорошо работает раздельный трек для упоминаний топ-менеджеров и компании, чтобы не смешивать контекст. Ниже фиксирую картинку, которая помогает визуализировать точки экономии и улучшения.
Если говорить про ROI, упор делаю на три составляющие: экономия времени, снижение рисков и качество коммуникации. Экономия времени - прямые часы команды, минус ручной мониторинг и сводка, плюс меньше совещаний по «куда пропало». Снижение рисков - штрафы и репутационные пробелы, в цифрах это всегда неприятно, но очень наглядно после пары кейсов. Качество коммуникации - быстрее отрабатываем негатив, аккуратно подхватываем позитив, прозрачнее делимся статусом. В итоге n8n мониторинг становится не просто инструментом, а привычкой команды работать ровнее и спокойнее. Это чувствуется по тому, как снижаются авралы и как выравнивается ритм недели.
Какие цифры фиксировать с первой недели
Я веду короткий дашборд на четыре- пять показателей, чтобы не утонуть в деталях. Важно, чтобы все метрики считались одинаково и не зависели от «ручного определения». Порог реакции согласую заранее и фиксирую в регламенте - это избавляет от споров при форс-мажоре. Если команда видит одну страницу с одинаковыми для всех правилами, разговоры про «мне показалось» заканчиваются сами собой. За месяц обычно видно тренд и можно свернуть ненужные источники или добавить новые. Это означает, что система сама подсказывает, где она избыточна, а где её нужно укрепить.
Как визуализировать результат, чтобы команда поверила
Берите три простых графика: время до алерта, время до реакции, доля шума. Потом добавляйте разрезы по каналам и типам событий. Чем ближе визуализация к ежедневной работе, тем быстрее команда принимает новые правила. Графики не должны жить в вакууме - прикрепляйте их к еженедельному отчёту, и это станет частью общего ритма. Я люблю аккуратные мини-доски в общем доступе, где видно только актуальные статусы без лишних деталей. Через пару недель цифры начнут работать за вас и спорить с мифами. Получается, что мы готовим не презентацию ради презентации, а рабочий инструмент, который облегчает решение спорных вопросов.
Какие подводные камни встречала и как обходить
Чаще всего встречаю завышенные ожидания от «кустарных» парсеров и недооценку правовой части. Я видела, как в алерты улетали имена и телефоны, потому что никто не подумал про маскирование - и приходилось срочно выключать цепочку. Ещё одна классика - хранить всё на зарубежном сервисе «пока тестируем», а потом забыть выключить. Это критично, потому что проверка часто приходит не тогда, когда удобно, и выясняется, что вы тестируете уже третий месяц. Технически n8n не подведёт, если аккуратно настроены таймауты, обработка ошибок и повторные попытки. Но организационно важно перепроверить роли, доступы и регламент на удаление данных. На такой проверке у меня обычно всплывает пара мелких дыр, которые закрываются за час, и дальше система живёт устойчиво.
Плохие новости лучше поймать раньше - добавьте тревогу о «тишине» потока, чтобы не пропустить сбой интеграции или истёкший токен. Это простая нить, за которую легко потянуть в начале дня.
Второй частый камень - перегрев автоматики: люди пытаются автоматизировать всё вплоть до ответов. Я оставляю финальное решение человеку, особенно если речь идёт о юридически значимых последствиях. Это означает, что мы ускоряем рутину, но не перекладываем ответственность на робота. Ещё тонкий момент - границы публичного доступа. Не все площадки разрешают парсинг одинаково, и тут работает простая логика: используем официальные API, уважаем правила, не лезем в серые зоны. На российских проектах так спокойнее всем, от продуктологов до юристов. С технической стороны, если поток нестабилен, я проверяю расписания, сводные лимиты и очереди повторов - иногда проблема банально в конфликте таймеров.
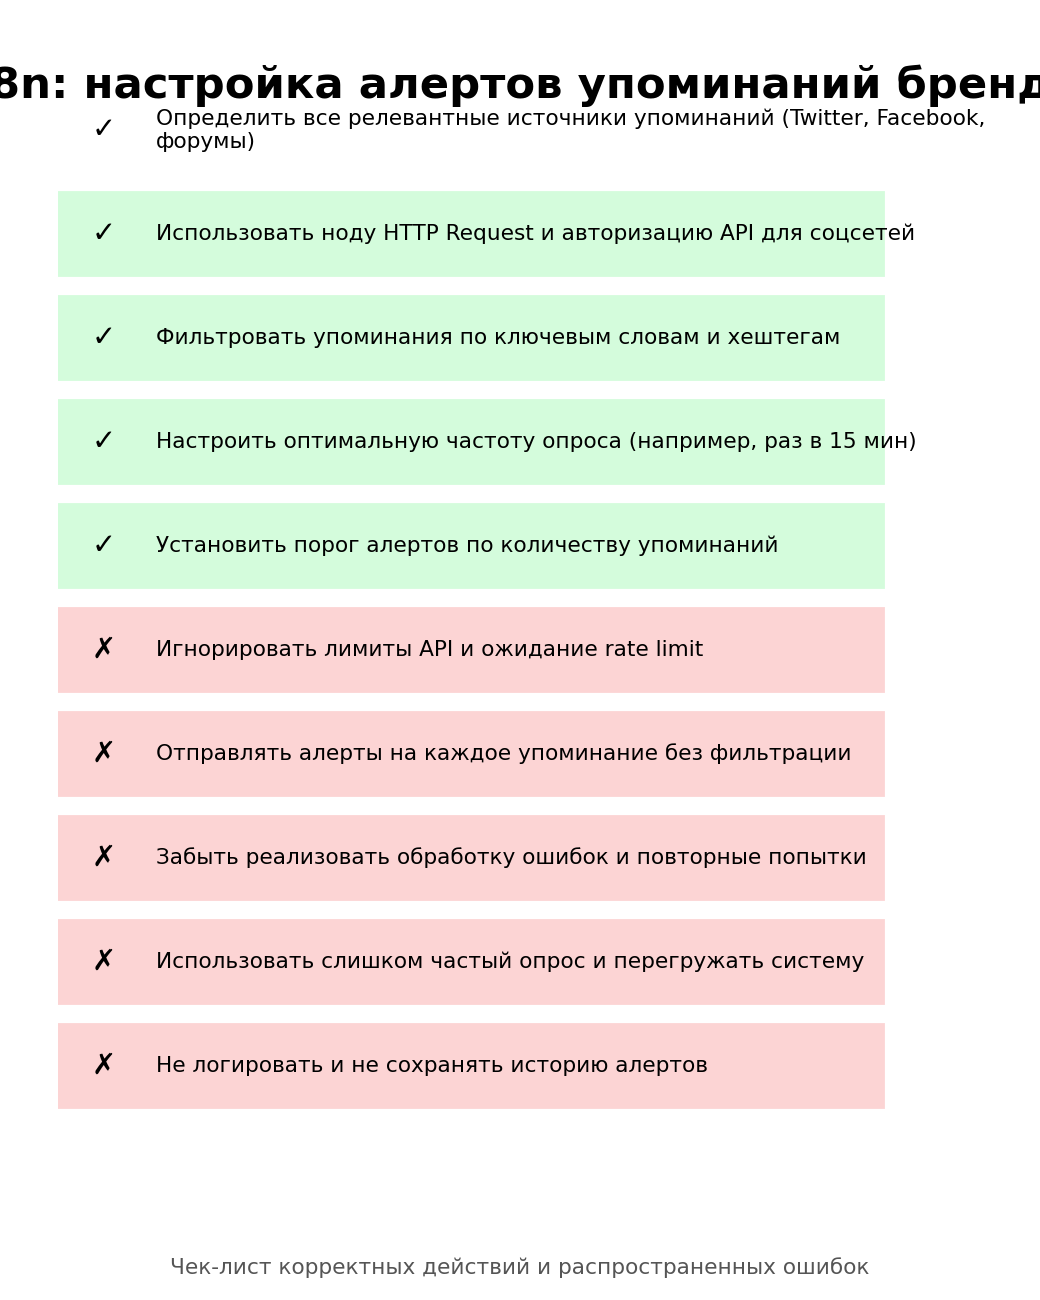
Для удобства приложу карточку с опорными пунктами, которые мы обсуждаем с командами перед запуском. Это помогает не терять важные детали и держать весь контур под контролем.
И ещё чуть-чуть быта. У меня был проект, где n8n упрямо не запускал один узел, и мы трижды поднимали контейнеры, пока не выяснили, что дело в обновлении расширения для парсинга. Грустно, но полезно: теперь я проверяю версии модулей не только на старте, но и по расписанию. Получается, что маленькие чекпоинты спасают часы расследований. А если добавить мониторинг «тишины», сбой чувствуется почти сразу. Это не делает систему бессмертной, но заметно уменьшает сюрпризы.
Где чаще всего ломается логика
Первые трещины возникают на границе фильтров и алертов: слишком широкие ключи, слишком разговорные правила, побочные совпадения. Люди надеются, что «так сойдёт», а потом удивляются, почему оповещений стало слишком много. Проще поджать словарь, ввести исключения и прогнать пару недель итеративно. Я оставляю в журнале причины срабатывания, чтобы смотреть, что именно привело к алерту. Это даёт тонкую настройку и снимает 50 процентов лишних тревог в первые дни. Если всё равно шумно, выносите каналы на разные пороги и не стремитесь унифицировать с первого раза. Так логика постепенно стабилизируется.
Как не попасть в правовые ловушки
Я начинаю со списка целей обработки и локализации, дальше выясняю, есть ли ПДн и какие поля критичны. Алерты собираю минималистично: ссылка, контекст, тональность, приоритет - остальное в закрытом контуре. Для согласий использую отдельные механизмы, а не строки мелким шрифтом, и веду учёт в журнале. Если кто-то просит удалить информацию, у меня готов маршрут для этого запроса. В результате автоматизация остаётся в белом поле, а риски снижаются до разумного минимума. Да, это дисциплина, но без неё мониторинг превращается в тонкий лёд, по которому долго не пройти.
Какие практические настройки я использую ежедневно
На ежедневном уровне рулят мелочи: корректное расписание, канарейка «тишины», маскирование перед алертами, понятные роли и короткие регламенты. Я делаю алерты по уровням: высокий приоритет - сразу человеку, средний - в общий канал, низкий - в сводку. Формат сообщений грациозно лаконичен: заголовок, цитата, ссылка, приоритет. В нём нет ПДн, зато есть всё, чтобы принять решение и пойти по маршруту. Технические детали прячу в логи, а комментарии - в карточки инцидентов. Плюс отдельный поток для позитивных упоминаний, чтобы отмечать хорошие кейсы и поддерживать команду. Получается, что система не только тушит пожары, но и помогает видеть светлые стороны.
Самая надёжная автоматика - та, которую можно объяснить за две минуты новому человеку. Если объяснение длиннее, срежьте лишнее и вернитесь к принципу минимизации.
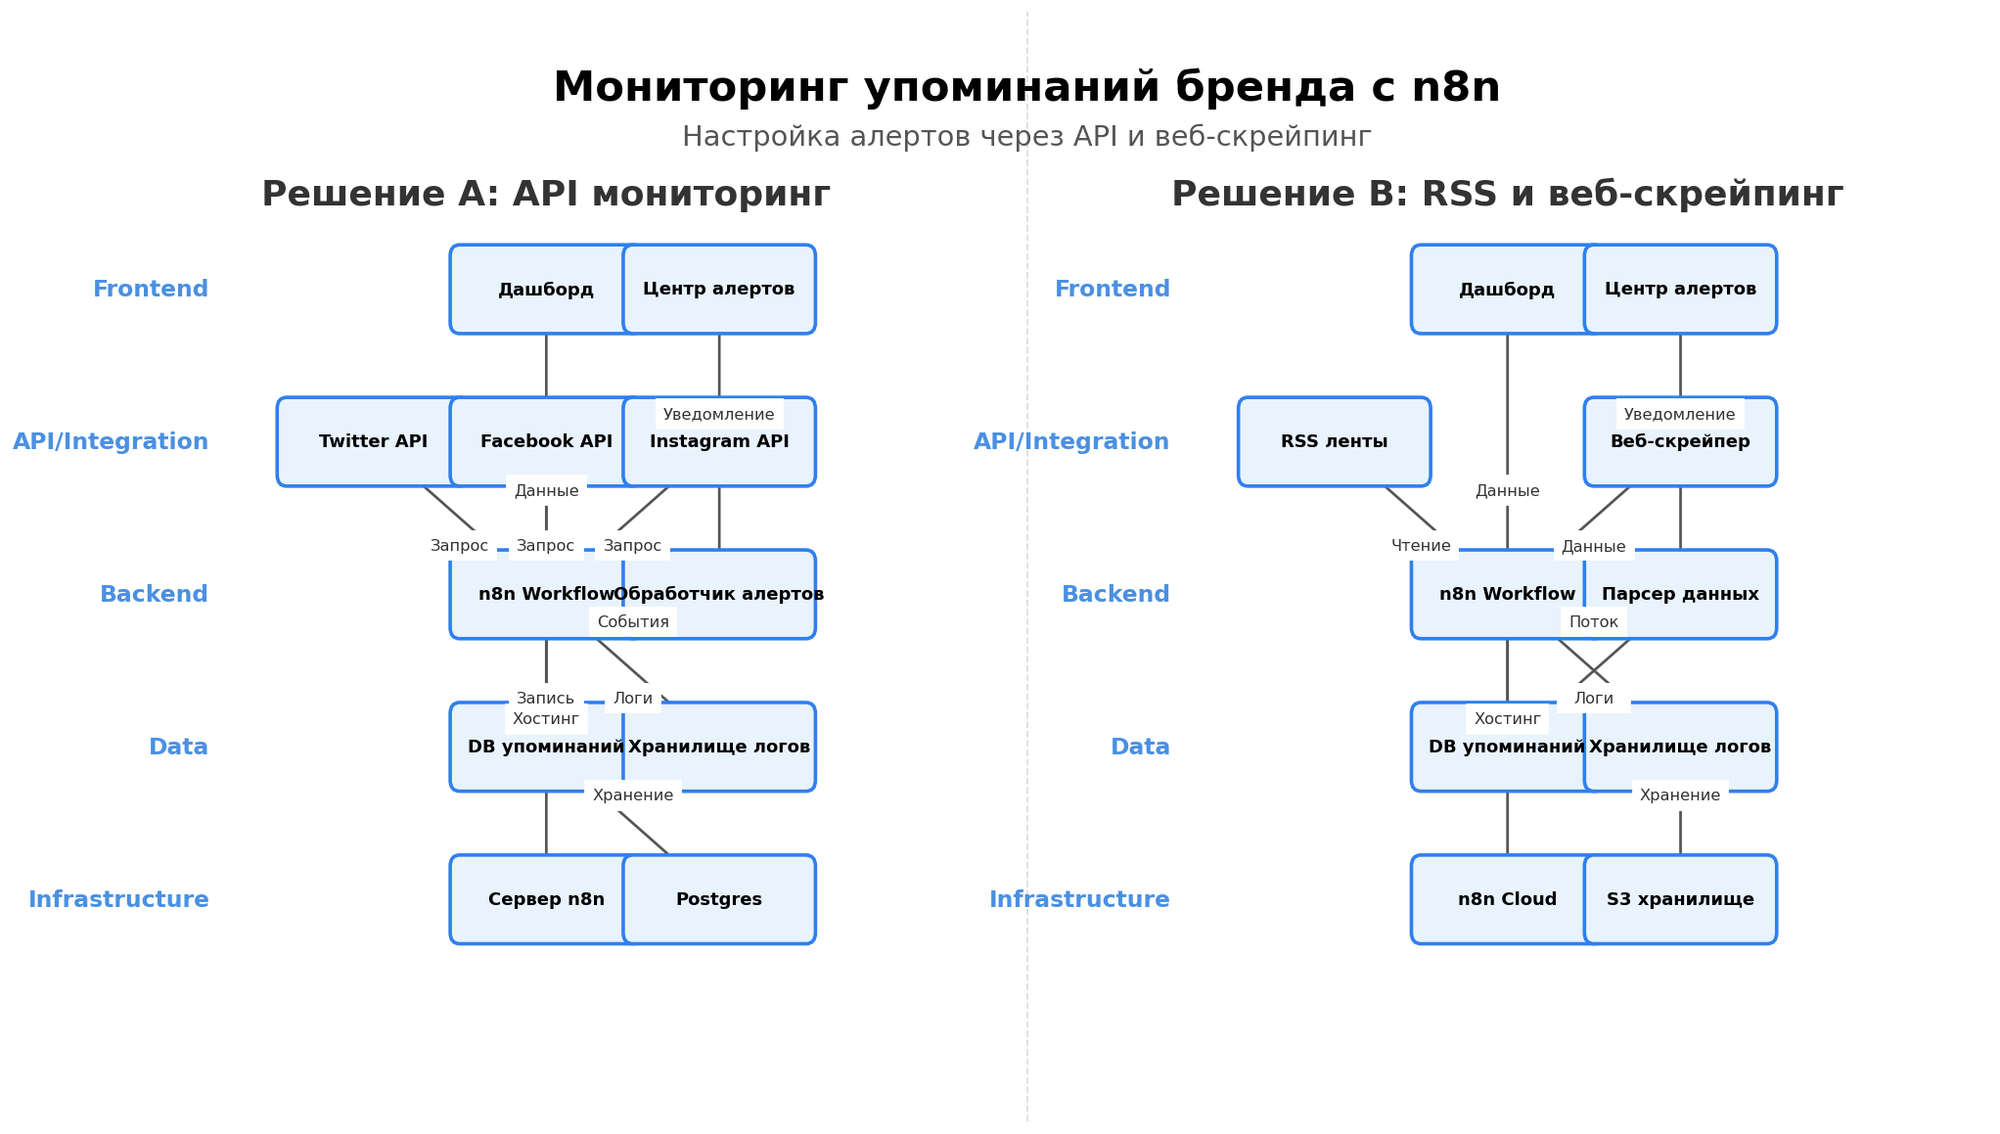
По каналам интеграций я оставляю короткие памятки: VK - частые вызовы, YouTube - осторожно с лимитами, Дзен - следите за структурой ответа. Если нужен каталог инцидентов, делаем лёгкую таблицу в локальной базе и добавляем поле для ручного статуса. Я заметила, что вопросы «а где это лежит» исчезают, когда у системы есть один понятный адрес. Это означает, что командные онбординги сокращаются, а качество реакции растёт. Для закрепления покажу ещё одну схему - как выглядит «скелет» решения с точки зрения архитектуры и взаимодействий.
Для тех, кто любит копаться глубже, я веду подборку методичек и разборов на своём сайте - можно почитать про автоматизация через n8n и посмотреть схемы реальных внедрений. Системность тут важнее любой «суперноды», и она выплывает в мелочах: как вы ведёте журналы, как настраиваете роли, как отвечаете на запросы удаления данных. Если эти кирпичики на месте, всё остальное сложится как конструктор. Для вдохновения можно заглянуть и на мой сайт о системной автоматизации и нативных практиках - я периодически обновляю раздел с гайдами и схемами. Это помогает собраться и нарисовать собственную карту действий.
Как оформить документацию, чтобы не тонуть
Я держу короткие файлы: цели обработки, схема потоков, роли и доступы, план реагирования, правила удаления. Каждый документ - одна страница, всё лишнее уходит в приложения. Это удобно для проверок и для команды: не нужно листать километры текста. Регламенты живут рядом с воркфлоу, а не в забытой папке, иначе они быстро стареют. Раз в квартал делаю короткий ревью - свежим взглядом ловятся заусенцы. Получается аккуратная «папка проекта», которая экономит часы на каждом обсуждении.
Какие ритуалы помогают держать систему в тонусе
Еженедельная проверка лимитов API, ежемесячная ревизия словаря ключей, квартальный аудит логов. Маленькие, но регулярные шаги в совокупности дают устойчивость больше, чем один большой «генеральный» апдейт. Я люблю ритуалы, потому что они снимают тревогу и задают ритм. Если что-то идёт не так, видно сразу, а не через три месяца. Для команды это превращается в привычку, которая не требует усилий. В результате мониторинг остаётся живым и полезным, а не превращается в «ещё один забытый проект». Ниже зафиксирую пару ежедневных шагов, чтобы было под рукой.
- Правило: проверка «тишины» потока утром - токены, очереди, расписания.
- Правило: быстрый взгляд на время до алерта - не растёт ли.
- Правило: разбор одного шумного срабатывания - зачем он вообще случился.
- Правило: минимальная корректировка словаря - по свежим кейсам.
- Правило: запись заметки в журнал - что поправили и почему.
Иногда достаточно одной недели таких ритуалов, чтобы система перестала шататься. В остальном всё как в спорте: регулярность важнее героических рывков. Если держать этот темп, мониторинг становится тихим, предсказуемым и очень полезным фоном для всей команды.
Тихая развязка и что в итоге меняется
Я люблю, когда автоматизация не шумит, а просто работает: алерты приходят, решения принимаются, данные лежат в нужном месте и не расползаются в мессенджерах. В российской реальности этот эффект достигается не одной кнопкой, а набором аккуратных практик: локализация, минимизация, прозрачные роли и честные метрики. Мы прошлись по всей цепочке - от источников до хранения - и собрали понятный базис, где n8n выступает оркестратором, а команда поддерживает правильный ритм. С точки зрения закона всё тоже складывается: отдельные согласия, запрет на автоматические юридически значимые решения, алгоритмы обезличивания по пути к алертам. Это не тормозит, а наоборот ускоряет, потому что система сразу строится устойчивой и проходящей аудит. Я заметила, как после запуска люди спокойнее реагируют на любые всплески - просто есть карта, роли и понятные границы. Если добавить немного дисциплины по проверкам и ритуалам, мониторинг держит форму месяцами, а команда возвращает себе время. Получается не быстрый трюк, а осознанный темп, который на длинной дистанции всегда выигрывает.
Для тех, кто готов из теории перейти в практику
Если хочется структурировать эти знания под свои процессы и отрасль, можно начать с малого - описать источники, пороги, роли и собрать первый поток в n8n. Когда рука ляжет, добавляйте ИИ-агента на обезличенных данных и настраивайте приоритизацию. Я периодически разбираю такие кейсы у себя и делюсь рабочими схемами без воды. Если нужна поддержка, загляни в мой канал с разбором n8n, агентами и белой автоматизацией - там я показываю «как это живёт» в ежедневной практике. А за системной картиной и материалами можно вернуться на сайт, где я собираю лаконичные методички и схемы. Здесь нет агрессивных призывов, только приглашение к аккуратной практике, которая экономит часы и держит курс в белом поле.
Что ещё важно знать
Как запустить n8n мониторинг, если нет доступа к API площадки?
Используйте легальные официальные источники данных и RSS, а для закрытых площадок работайте через предусмотренные механизмы. Парсинг без разрешения лучше не применять, чтобы не нарушать правила платформы и закон.
Можно ли строить алерты только в Telegram и ничего не хранить?
Можно, если вы не обрабатываете ПДн и вам не требуется журналирование инцидентов. Для большинства команд полезно хранить минимальные логи в РФ: ссылка, время, канал и тональность.
Что делать, если алертов слишком много и команда тонет?
Сузьте ключевые слова, добавьте исключения, разделите каналы по порогам и уменьшите частоту вызовов. Дополнительно включите ручную валидацию для событий со спорной тональностью.
Как подключить настройка ноды airtable в n8n и не нарушить локализацию?
Не передавайте ПДн и чувствительные данные в AirTable, оставляйте там только технические метаданные. Для ПДн используйте локальную базу в российских дата-центрах.
Есть ли смысл ставить n8n настройка агента на первом этапе?
Лучше сначала добиться стабильности базовой цепочки и метрик, затем добавлять агента для классификации и приоритизации. Это позволит понять реальную пользу и избежать «избыточной сложности».
Что делать, если упоминания приходят волнами и сбивают расписание?
Добавьте буферную очередь и плавающий интервал опроса, а также приоритеты по каналам. Это сгладит пики и избавит от лавины ложных тревог.
Можно ли переносить настройки между проектами без правок?
Базовая структура переносится, но словари, пороги и источники всегда дорабатываются под контекст. Проведите короткое тестирование и ревизию ролей перед запуском.
Автоматизация воронок продаж
Лид от комментария до оплаты без ручного менеджера, запуск за 10–14 дней

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


