


Каждый раз, когда на совещании кто-то предлагает "уже наконец внедрить нейросеть", я задаю один вопрос, после которого в комнате ненадолго становится тихо: какие данные вы собираетесь в неё отправлять. Российские нейросети для работы я выбираю именно по этому вопросу, и только потом по тому, какая из них изящнее пишет письма.
Семнадцать лет в корпоративном ИТ и внутреннем аудите приучили меня смотреть на любой новый инструмент со стороны данных: что в него входит, где это хранится, кто это увидит и как потом доказать проверяющему, что все было законно. Нейросеть здесь ничем не отличается от облачного диска или почтового сервиса, просто её гораздо проще недооценить.
Сотрудник, который вставляет в чат договор с поставщиком, чтобы быстро найти в нем риски, думает о задаче и совершенно искренне не думает о том, что текст договора только что покинул периметр компании. Поэтому ниже я разбираю выбор в том порядке, в каком делаю его сама, и в конце отдаю таблицу, которую можно выдать любому отделу.
Почему выбор начинается с данных
Сравнение нейросетей чаще всего начинают с качества ответов: кто лучше понимает русский язык, кто аккуратнее считает, кто меньше выдумывает. Для личного пользования это разумные критерии, но в компании они вторичны, потому что самая сильная модель становится проблемой, если в неё ушли данные клиентов без правового основания.
Закон о персональных данных требует, чтобы при сборе данных граждан России через интернет их запись и хранение шли в базах на территории страны, поэтому зарубежные сервисы для рабочих задач с клиентами и сотрудниками требуют отдельной проверки юриста.
Российские сервисы снимают вопрос локализации, однако вопросы договора, целей обработки и доступа к вашим запросам остаются за вами.
Вторая причина заметна меньше: коммерческая тайна, цены закупки и черновики стратегии не относятся к персональным данным, однако их утечка стоит денег, и закон о персональных данных здесь ничем не подстрахует. В аудите шутят, что надёжнее всего защищены данные, о которых никто не знает, но проверяющие с этим почему-то не согласны.
Три класса данных, по которым решают все остальное
Для рабочих решений мне хватает трёх классов, и каждый сотрудник способен отнести к одному из них любой документ за секунды, без юриста и без толстого регламента, который все равно никто не дочитает.
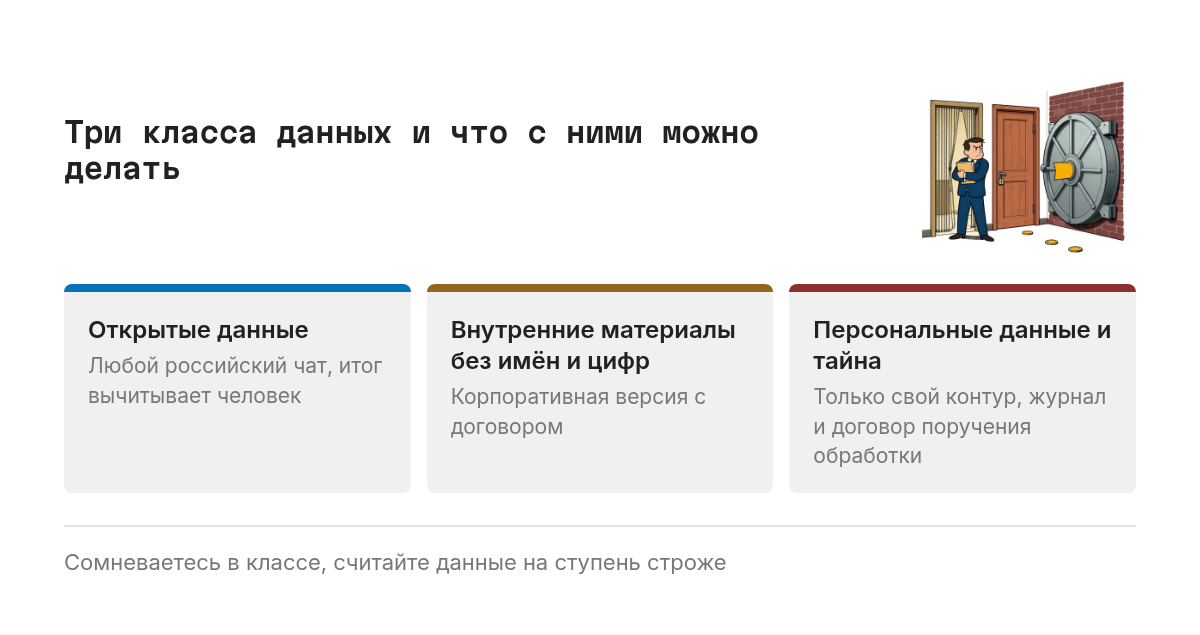
Зелёный класс это все, что вы и так готовы опубликовать: тексты для сайта, описания товаров, публичные документы, варианты заголовка для рассылки. Для него подходит любой российский чат-сервис, включая бесплатную личную версию, и единственное условие качества в том, что итог перед публикацией вычитывает человек.
Жёлтый класс составляют внутренние материалы без имён и без коммерческих цифр: черновики регламентов, инструкции, шаблоны писем, протоколы встреч, где участников заменили ролями. Здесь уже нужна корпоративная версия с договором, в котором прописано, идут ли ваши запросы на обучение модели и кто со стороны поставщика имеет к ним доступ.
Красный класс включает персональные данные, коммерческую тайну и все, что попадает под соглашения о конфиденциальности. С ним работают только в контуре, который вы контролируете: доступ к модели из вашего кода, договор поручения обработки, журнал запросов и обезличивание до отправки, если без имён задача решается так же хорошо.
Какие российские нейросети есть под рабочие задачи
Для компании выбор чаще всего сводится к двум крупным семействам моделей, у которых есть и чат для людей, и доступ для разработчиков, и корпоративные условия. Остальное либо надстройки над ними, либо открытые модели, которые разворачивают на своих серверах, и это отдельный разговор про бюджет на оборудование и людей.
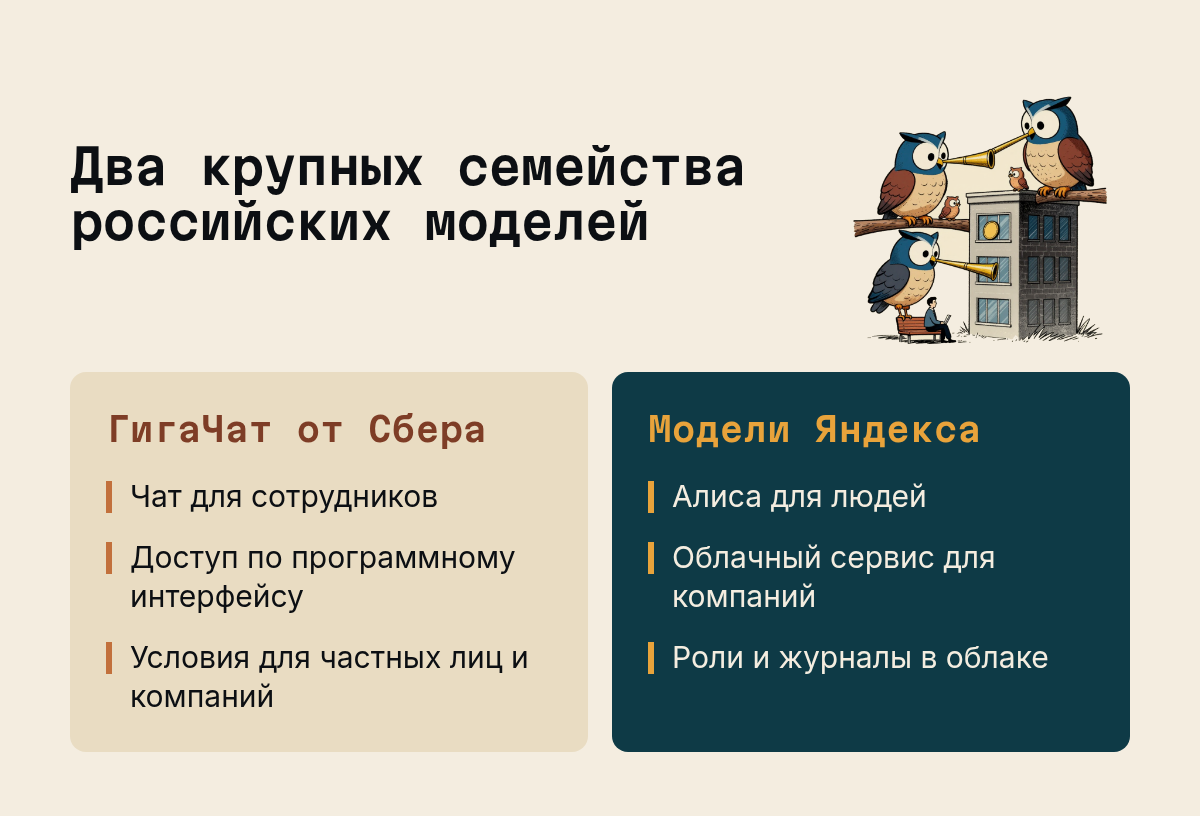
ГигаЧат от Сбера доступен в виде чата и через программный интерфейс, а условия подключения для частных лиц и для компаний описаны в документации ГигаЧата для разработчиков, куда стоит отправить ИТ-службу раньше, чем кто-то оплатит подписку с корпоративной карты.
Модели Яндекса работают в Алисе для людей и в облаке для компаний, где доступ оформляется как облачный сервис с платёжным аккаунтом и ролями, как описано в документации Яндекс Облака по генеративным моделям. Удобно, что права, журналы и оплата живут там же, где остальная облачная инфраструктура, если она у вас уже есть.
Сравнивать модели по качеству ответов в отрыве от задачи бессмысленно, потому что обе регулярно обновляются и вывод из прошлогоднего обзора, скорее всего, уже устарел. Полезнее прогнать на обеих набор своих типовых запросов из зелёного класса и посмотреть, какая чаще попадает в ваш тон и реже требует правок.
Уровни доступа: от вкладки в браузере до своего контура
Одна и та же модель может жить в компании на разных уровнях, и риск определяется уровнем доступа гораздо сильнее, чем названием модели на логотипе.
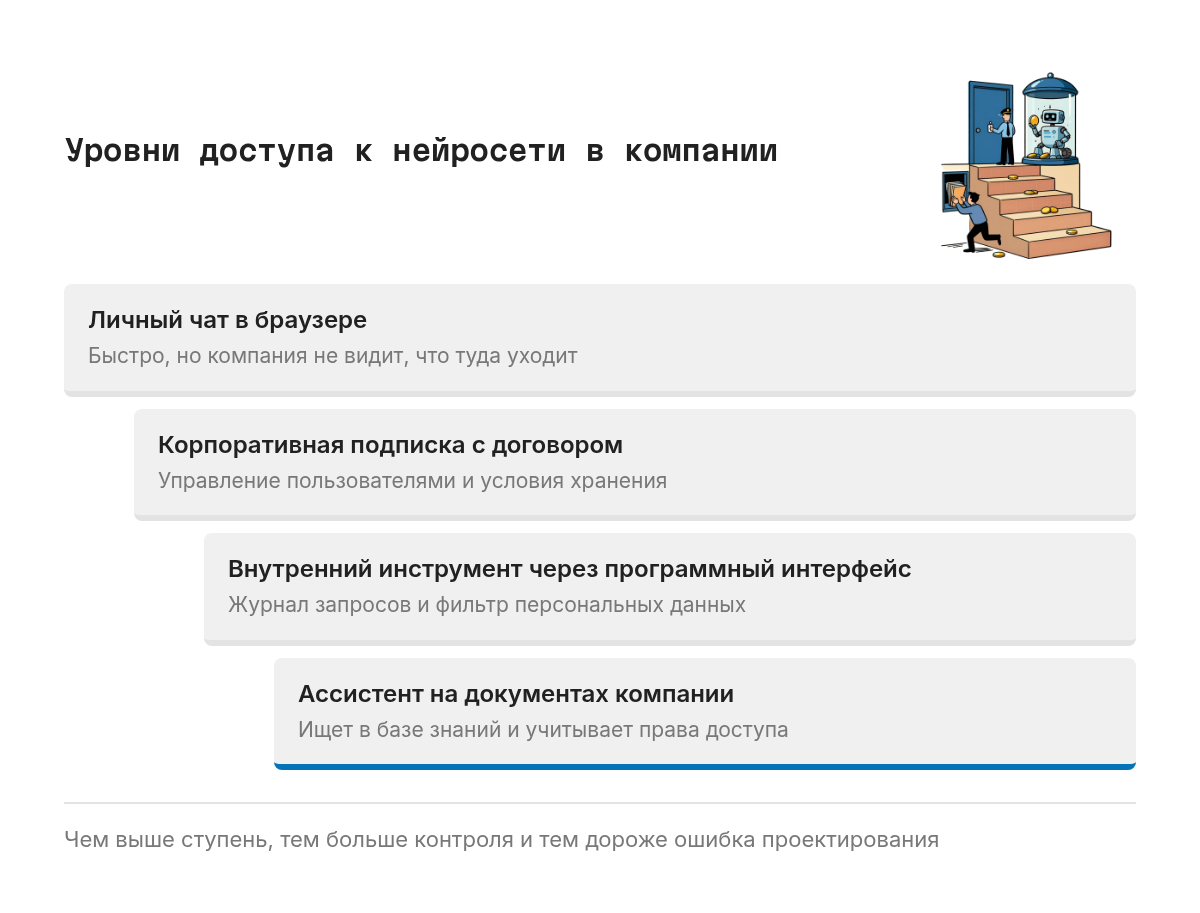
Личный чат в браузере даёт скорость и почти никакого порога входа, но компания не видит, что туда отправляют, и ничего не может показать при проверке. Корпоративная подписка с договором добавляет управление пользователями и понятные условия хранения запросов, и для жёлтого класса этого обычно достаточно.
Следующий уровень означает, что сотрудники работают через внутренний инструмент, который обращается к модели по программному интерфейсу: так появляются журнал запросов, фильтр персональных данных перед отправкой и возможность быстро сменить поставщика, не переучивая людей.
Верхняя ступень это ассистент на ваших собственных документах, который ищет ответ в базе знаний компании и учитывает права доступа, так что бухгалтер не получит в ответе выдержку из кадровых приказов. На этом уровне нейросеть начинает экономить время всей компании, и здесь же ошибки проектирования обходятся дороже всего.
Что проверить у сервиса до первого рабочего запроса
Прежде чем разрешать сервис для жёлтого или красного класса, я прохожу короткий список вопросов, ответы на которые ищу в договоре или официальной документации, потому что устные заверения менеджера при проверке ничего не весят.
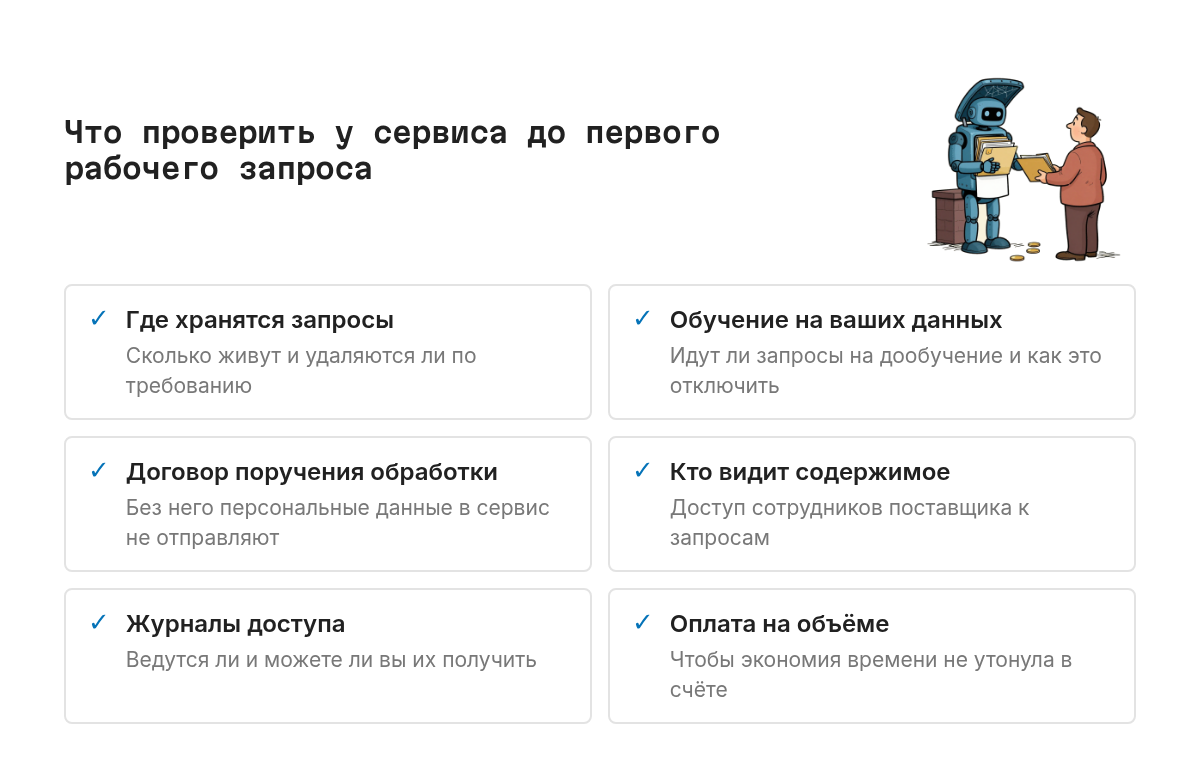
Первым делом выясняю, где физически хранятся запросы и ответы, сколько они живут и можно ли удалить их по вашему требованию. Затем смотрю, используются ли ваши данные для дообучения модели и как эта опция отключается, если она вообще предусмотрена условиями.
Дальше проверяю, есть ли договор поручения обработки персональных данных, кто у поставщика видит содержимое запросов и можете ли вы получить журналы доступа. Последним смотрю, как устроена оплата на объёме, чтобы экономия времени сотрудников не утонула в счёте, о котором финансовый директор узнает последним.
Таблица: какую нейросеть брать под задачу и данные
Эту таблицу я бы выдала любому отделу вместе с разрешением пользоваться нейросетями: каждая строка отвечает, какой класс данных у задачи, где её можно решать и что сделать с текстом до отправки.
Посты, статьи и описания товаров относятся к зелёным данным, поэтому их можно готовить в любом российском чат-сервисе, включая личную версию, при условии, что факты и цифры в итоговом тексте сверяет человек.
Пересказ и перевод публичных документов тоже работают с зелёными данными и решаются в любом российском чат-сервисе, если ссылка на оригинал остаётся в итоговом тексте.
Черновики регламентов, инструкций и шаблонов писем относятся к жёлтым данным, их готовят в корпоративной версии с договором, предварительно убрав из текста имена, названия контрагентов и суммы.
Протоколы и выжимки встреч остаются жёлтыми, пока участники заменены ролями, и работают с ними в корпоративной версии при условии, что в тексте нет коммерческих цифр.
Разбор договоров и коммерческих предложений относится к красным данным и делается только во внутреннем инструменте с доступом к модели по программному интерфейсу, где есть договор с поставщиком, запрет обучения на ваших запросах и журнал.
Обращения клиентов, резюме и анкеты содержат красные персональные данные, поэтому обрабатываются только в вашем контуре с договором поручения обработки, а до отправки их обезличивают, если задача это позволяет.
Ответы сотрудникам по базе знаний касаются жёлтых или красных данных и строятся на ассистенте на ваших документах, в котором права доступа наследуются из исходных систем.
Анализ выгрузок продаж и отчётов работает с красными данными во внутреннем инструменте или корпоративной версии, если выгрузка очищена от имён клиентов и цен закупки.
Программный код обычно относится к жёлтым данным и становится красным, если в нем есть ключи и адреса систем, поэтому его отправляют в корпоративную версию только после того, как секреты вычищены.
Для задач, которых в таблице нет, правило простое: если сомневаетесь в классе, считайте данные на ступень краснее, потому что переоценка риска стоит времени на обезличивание, тогда как недооценка может обернуться разговором с регулятором.
Строки, где ассистент работает на ваших документах и учитывает права доступа, требуют проектирования: откуда берутся документы, как обновляется поиск по ним, что пишется в журнал.
Такие ассистенты на данных компании я собираю под конкретный бизнес и начинаю любой проект с этой же таблицы, потому что без неё архитектуру потом приходится переделывать.
Частые вопросы о российских нейросетях
Можно ли загружать рабочие документы в бесплатную нейросеть?
Можно, если документ относится к зелёному классу и вы готовы увидеть его в открытом доступе без последствий для компании. Регламенты, договоры и любые документы с именами людей в бесплатную личную версию отправлять нельзя, потому что компания не контролирует ни хранение запросов, ни доступ к ним.
Какая российская нейросеть лучше для работы с текстами?
Лучшую выбирают на ваших собственных типовых запросах, потому что модели регулярно обновляются и чужие сравнения быстро устаревают. Соберите набор реальных задач из зелёного класса, прогоните его через ГигаЧат и модели Яндекса и оставьте ту, чьи ответы реже требуют правки.
Чем корпоративная версия нейросети отличается от личной?
Корпоративная версия даёт договор, управление пользователями и прописанные условия хранения и использования запросов, то есть все, что можно показать проверяющему. Личная версия удобна для открытых данных, но в ней компания не видит, кто из сотрудников и что именно туда отправлял.
Нужно ли согласие клиентов, чтобы обрабатывать их данные нейросетью?
Нужно правовое основание для такой обработки, и чаще всего вопрос закрывают договором поручения обработки с поставщиком сервиса и соответствующим пунктом в вашей политике обработки данных. Конкретную схему стоит согласовать с юристом, а самый простой способ снять вопрос состоит в том, чтобы обезличить данные до отправки.
Что проверить у себя сегодня
Откройте историю своих запросов в нейросетях, попросите нескольких коллег из разных отделов сделать то же самое и разложите увиденное по трём классам данных, не выясняя пока, кто и зачем это отправлял.
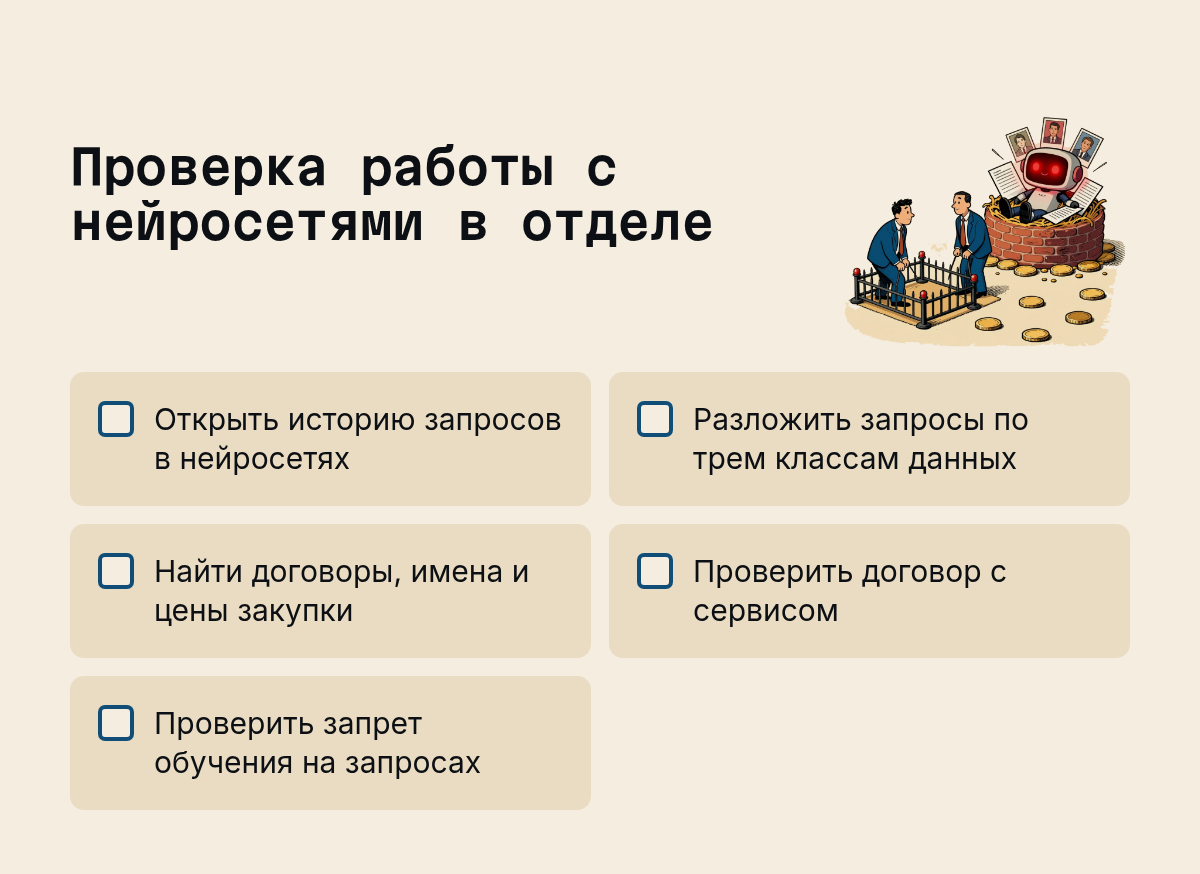
Если в истории нашлись договоры, выгрузки с именами или цены закупки, у компании уже есть работа с нейросетями на красном уровне, просто без договора, журнала и правил, и таблица выше подскажет, какой уровень доступа нужен каждой такой задаче.
Отдельно проверьте, заключён ли с выбранным сервисом договор от имени компании и прописан ли в нем запрет обучения на ваших запросах. Пока договора нет, сервис годится только для зелёного класса, как бы хорошо он ни писал письма.
Какие задачи в вашем отделе уже ушли в нейросеть, и в какой цвет вы бы их покрасили после этой таблицы?
Новые разборы выходят в моём канале: t.me/promaren.
AI-ассистенты: экономия 4 часа в день
RAG-помощник на ваших данных и регламентах
Первоисточники
Частые вопросы
Можно ли загружать рабочие документы в бесплатную нейросеть?
Можно, если документ относится к зелёному классу и вы готовы увидеть его в открытом доступе. Регламенты, договоры и документы с именами людей в бесплатную личную версию отправлять нельзя: компания не контролирует ни хранение запросов, ни доступ к ним.
Какая российская нейросеть лучше для работы с текстами?
Лучшую выбирают на своих типовых запросах, потому что модели регулярно обновляются и чужие сравнения быстро устаревают. Прогоните реальные задачи через ГигаЧат и модели Яндекса и оставьте ту, чьи ответы реже требуют правки.
Чем корпоративная версия нейросети отличается от личной?
Корпоративная версия даёт договор, управление пользователями и прописанные условия хранения и использования запросов. Личная версия удобна для открытых данных, но в ней компания не видит, кто и что отправлял.
Нужно ли согласие клиентов, чтобы обрабатывать их данные нейросетью?
Нужно правовое основание обработки, и обычно вопрос решается договором поручения обработки с поставщиком и пунктом в политике обработки данных. Схему стоит согласовать с юристом, а проще всего обезличить данные до отправки.

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


