

В понедельник утром аналитик присылает вам отчёт по упоминаниям бренда, и в нём ноль строк за выходные. Скрипт работает, ошибки в логах пустые, но данных нет. Так обычно и узнают, что источник закрылся: плата рассылает письмо о прекращении доступа и закрывает канал.
Reddit объявил, что прекращает поддержку RSS-лент и закрывает публичный доступ к API, и назвал причиной ИИ-ботов, которые выкачивали контент платформы в промышленных масштабах. Об этом пишет TechCrunch. Если вы хоть раз тянули с Reddit упоминания своей компании, отзывы о продукте или ветки для аналитики, этот сигнал адресован лично вам.
Что именно закрыли и почему
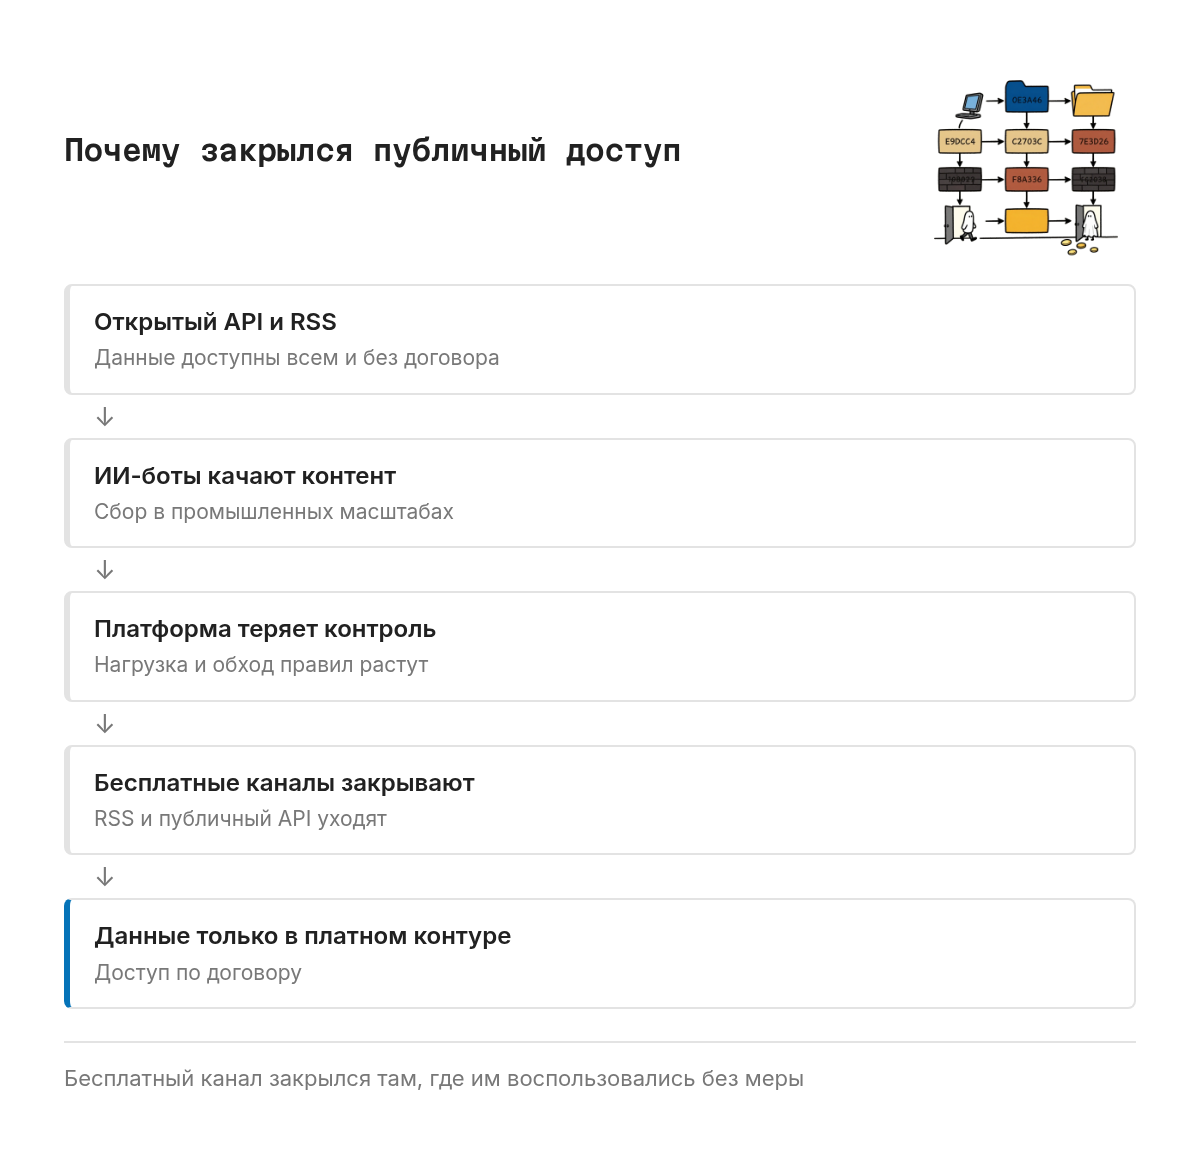
Механика решения простая, если разложить её по звеньям. Публичный API и RSS были созданы в эпоху, когда данными платформы пользовались читатели, отдельные разработчики и сервисы агрегаторов.
Потом появились ИИ-компании, которым нужен корпус человеческих разговоров для обучения моделей, и бесплатный канал превратился в трубу, из которой качают без меры.
Платформа отвечает так, как отвечает любой владелец актива: закрывает бесплатную трубу и оставляет платный контур с договором, лимитами и контролем, кто и зачем берёт данные. Это закономерный ход, и я бы не ждала, что Reddit станет последней площадкой с таким решением.
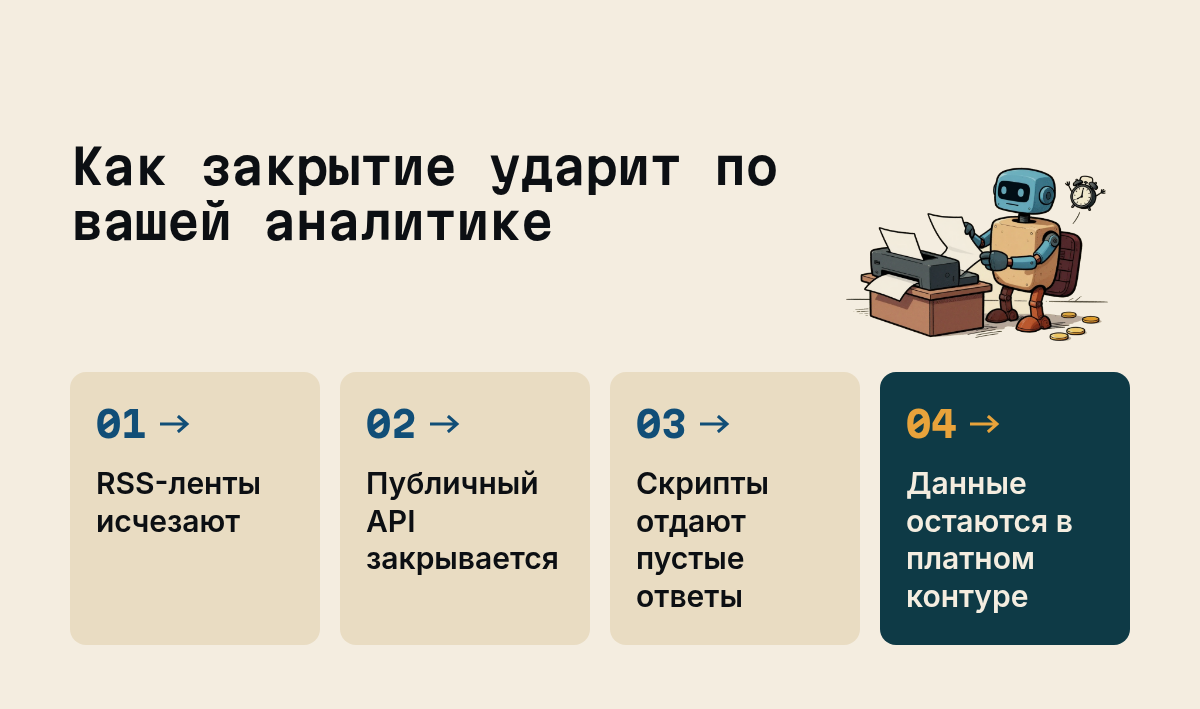
Для вас это значит одно: любой сбор данных с Reddit, который построен на публичных каналах, теперь работает на честном слове и сломается в любой день. Причём сломается тихо.
Почему поломку вы заметите не сразу
Самое коварное в закрытии API то, что скрипт редко падает с ошибкой. Чаще он продолжает крутиться по расписанию, получать пустые или урезанные ответы и складывать их в базу как валидные данные. Деградацию вы увидите через недели, когда однажды сравните динамику с прошлым кварталом и обнаружите обрыв.
Я семнадцать лет смотрю на такие вещи глазами аудитора, и в этом опыле есть одна привычка, которую советую перенять: любой источник данных без владельца и безSLA внутри компании это уже инцидент, просто ещё не обнаруженный. RSS-лента конкурента, публичный API форума, страница, которую вы парсите кроном, всё это одна категория риска.
Закрытие Reddit показало эту категорию всем, у кого она была закрыта от глаз. У одних источником были именно его ленты, у других что-то ещё, но принцип один: бесплатный открытый канал живёт до первого крупного бота, который его исчерпает.
Куда переносить сбор данных
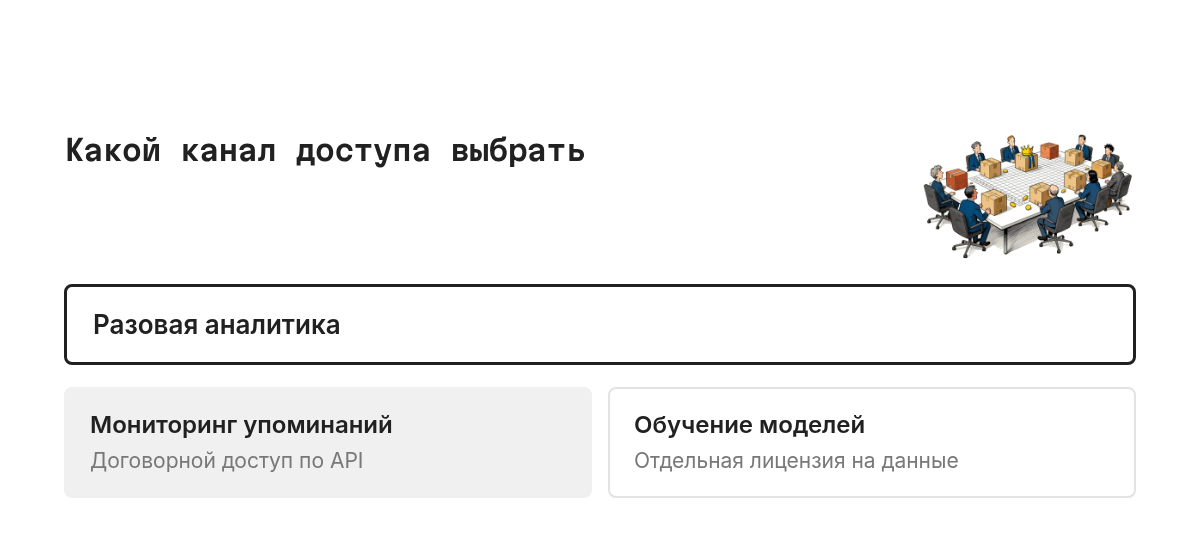
Выбор канала зависит от задачи, и здесь я советую разложить свои потребности по трём веткам: разовая аналитика, постоянный мониторинг, корпус для обучения моделей. У каждой задачи свой разумный путь, и цена ошибки разная.
Для обучения моделей потребуется отдельная коммерческая лицензия на данные, и это разговор уже не про скрипты, а про юристов.
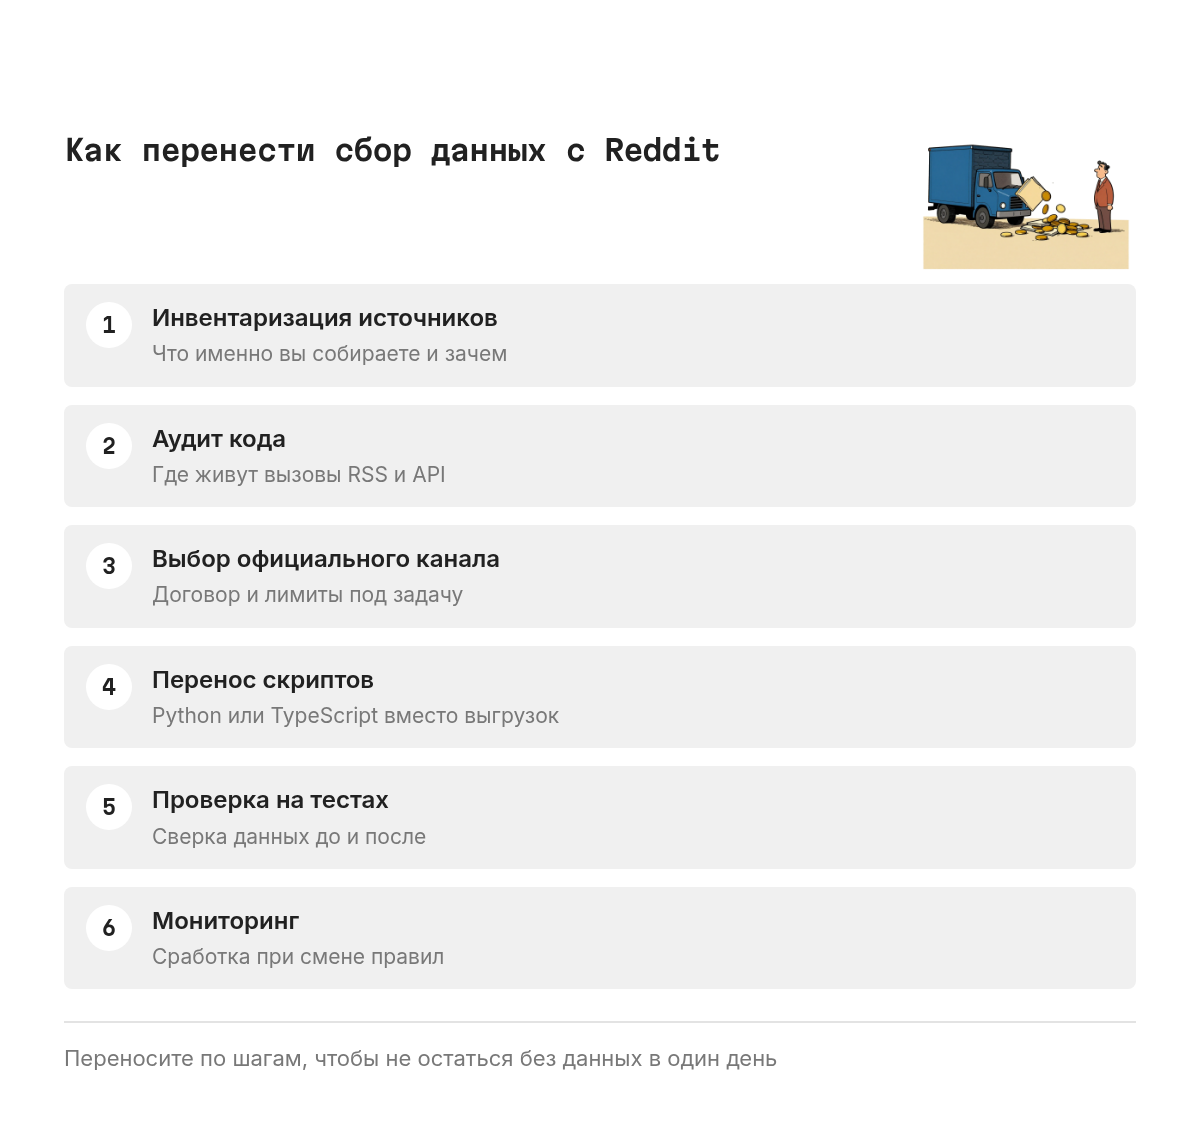
Технически перенос сборов я всегда делаю кодом на Python или TypeScript: скрипт, конфиг с источниками, логирование каждого ответа и алерт, когда данных пришло меньше ожидаемого. Именно алерт на аномально пустой ответ спасает от тихой деградации, о которой я писала выше.
Чек-лист переноса до последнего дня работы старых каналов
Ниже чек-лист, который можно прогнать по своим системам на этой неделе. Каждый пункт проверяемый, и если на каком-то вы застряли, это и есть ваше узкое место.
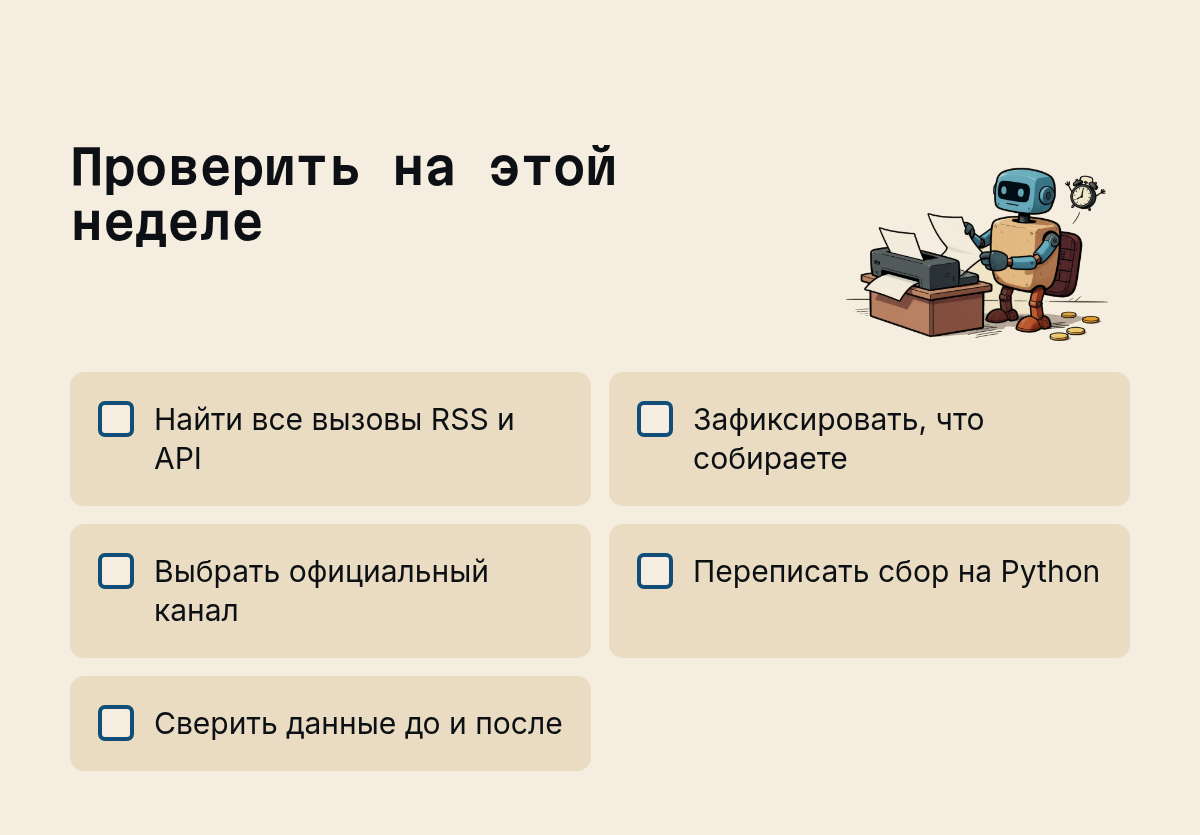
- Найти в кодовой базе все обращения к RSS-лентам и публичному API Reddit: поиск по репозиториям по домену платформы и по словам rss и feed.
- Зафиксировать в таблице, какие именно данные вы собираете: упоминания бренда, отзывы, ветки по темам, и кто внутри компании их потребляет.
- Определить для каждого потока задачу из трёх веток: разовая аналитика, постоянный мониторинг, обучение модели.
- Выбрать официальный канал доступа и запросить условия: лимиты, состав данных, цена, порядок согласования.
- Переписать сбор на Python или TypeScript с конфигом источников и логированием каждого ответа.
- Настроить алерт на аномально пустой ответ: пришло меньше данных, чем в среднем за прошлые периоды, значит сигнал в дежурный канал.
- Сверить данные за перекрывающийся период: объём, состав полей, полноту веток до и после переноса.
- Назначить владельца каждого потока данных: имя человека, иначе контроль умрёт вместе с проектом.
Последний пункт списка часто кажется бюрократией, пока не наступает день, когда источник меняет правила, и выясняется, что спросить не у кого. Владелец потока это тот, кто получит алерт и примет решение, чинить или закрывать.
Что почитать рядом
Тема закрытых данных шире одного Reddit. TechCrunch в тот же день опубликовал материал о том, что экономика потребительских ИИ-продуктов складывается тяжело, и эта статья хорошо объясняет, почему платформы так яростно защищают свои корпуса данных: именно они остаются активом, когда всё остальное в цепочке дешевеет.
Если вы собираете упоминания о бренде в нескольких каналах и хотите поставить этот процесс на рельсы, у PROMAREN есть готовая практика по ИИ-ассистентам и сбору данных, включая перенос источников на официальные API и настройку мониторинга, который сообщит о проблеме раньше, чем её увидит отчёт.
Вопросы, которые мне задают про закрытие API
Почему Reddit закрыл RSS и публичный API?
Платформа назвала причиной ИИ-ботов, которые массово выкачивали контент через открытые каналы. Бесплатный доступ превратился в трубу для сбора обучающих данных, и владелец актива закрыл её, оставив только официальные договорные каналы.
Мои скрипты перестанут работать в один день?
Скорее скрипты продолжат работать и начнут молча возвращать пустые или урезанные ответы, и это опаснее падения. Именно поэтому в чек-листе выше стоят логирование каждого ответа и алерт на аномально пустой выгруз, без них деградацию вы увидите по провалу в отчёте через недели.
Можно ли остаться на самодельном парсинге страниц?
Технически иногда можно, и на коротком горизонте это даже сработает, но решение хрупкое: платформа меняет вёрстку и правила без предупреждения, а обход официальных каналов создаёт юридический риск для компании. Я бы рассматривала такой вариант только как временный костыль с датой демонтажа в календаре.
Стоит ли ждать того же от других площадок?
Логика решения не специфична для Reddit: любой владелец корпуса человеческих текстов, на котором тренируют модели, получает стимул закрыть бесплатный доступ. Планируйте сбор данных так, чтобы смена правил одной платформы не роняла всю вашу аналитику.
Что проверить сегодня же
Запустите поиск по своим репозиториям по адресу платформы и по слову rss. Если нашли хотя бы одно обращение, у вас есть поток данных без SLA, и теперь вы знаете, как это чинить: инвентаризация, официальный канал, перенос на код, алерт, владелец.
У вас есть скрипты, которые тянут данные с площадок, давно не проверявшихся на предмет правил? Напишите, какие источники стоят у вас на кроне, и я разберу в следующем материале, как выстроить мониторинг так, чтобы тихая поломка становилась шумным алертом.
Новые разборы выходят в моём канале: t.me/promaren.
AI-ассистенты: экономия 4 часа в день
RAG-помощник на ваших данных и регламентах
Первоисточники

Частые вопросы
Почему Reddit закрыл RSS и публичный API?
Платформа прекращает поддержку RSS-лент и публичного доступа к API из-за ИИ-ботов, которые массово выкачивали контент. Для владельцев бизнес-аккаунтов и коммерческих проектов данные остаются доступными только через официальные договорные каналы.
Что делать, если мой скрипт собирает данные с Reddit через публичный API?
Проводите инвентаризацию: найдите все места в коде, где идут вызовы старых каналов, зафиксируйте, какие именно данные вы собираете, и выберите официальный канал доступа. После переноса обязательно сверьте объём и состав данных до и после.
Как следить за упоминаниями бренда после закрытия RSS?
Через официальные договорные каналы доступа: мониторинг упоминаний переводится на согласованный API, а сбор реализуется кодом на Python или TypeScript. Разовые задачи можно закрывать официальными выгрузками и отчётами.
Чем опасен самодельный парсинг после закрытия API?
Он ломается молча: скрипт продолжает работать, но возвращает пустые или неполные данные, и деградацию вы заметите только по провалу в отчётах. Кроме того, обход официальных каналов создаёт юридический риск для компании.

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


