
У подержанной Tesla V100 на 32 ГБ есть привлекательная особенность: за сравнительно старым ускорителем скрывается большой объём быстрой памяти. Но покупатель приобретает ещё и задачу по подбору совместимого программного окружения. В 2026 году именно она может оказаться дороже разницы в цене между картой и облачным сервисом.
Поэтому начинать расчёт стоит с конкретной модели и нагрузки. «Хочу свой ИИ» не определяет требования к серверу. Поиск по внутренним документам, расшифровка записей и несколько одновременных помощников для сотрудников требуют разных настроек. Важно заранее понять, какой результат нужен, сколько людей будет обращаться к системе и какую задержку они готовы терпеть.
32 ГБ помогают, но не обещают скорость
V100 относится к поколению Volta. В даташите NVIDIA указаны варианты с 16 и 32 ГБ HBM2, пропускная способность памяти 900 ГБ/с и максимальная мощность 250 Вт для PCIe либо 300 Вт для SXM2. Это разные исполнения: SXM2 нельзя считать обычной картой, которую достаточно вставить в свободный слот настольного компьютера.
Объём памяти ограничивает то, что можно держать на ускорителе одновременно. У языковой модели память нужна для весов, служебных буферов и кеша контекста — сохранённых промежуточных данных диалога. Если файл модели занимает почти весь доступный объём, для длинного разговора и нескольких пользователей места может не остаться.
Для грубой оценки можно посчитать сами веса. Условная модель на 14 миллиардов параметров при четырёх битах на параметр занимает около 7 миллиардов байт; на 30 миллиардов — около 15. Это арифметический нижний ориентир, а не размер готового файла и не обещание запуска. Реальное квантование добавляет служебные данные, часть слоёв может храниться с другой точностью, а контекст расходует память отдельно.
С моделью на 70 миллиардов параметров та же прикидка даёт уже 35 миллиардов байт до накладных расходов. Для одной V100 на 32 ГБ это повод сразу проверить распределение между GPU и оперативной памятью. Частичное выполнение на CPU иногда позволяет запустить задачу, но скорость меняется; оценивать её нужно на своей модели и длине запроса.
Главная проверка — совместимость всего набора
Название GPU в описании сервиса недостаточно. Нужна рабочая комбинация драйвера, CUDA, движка, формата модели и выбранных ускорений. Сохраните версии вместе с результатом пробного запуска: обновление одного компонента может потребовать пересборки другого.
Первое ограничение связано с точностью вычислений. V100 не имеет аппаратной поддержки BF16, появившейся в более поздних поколениях. Если инструкция к модели требует этот формат, выясните, поддерживает ли движок FP16 или подходящее квантование. BF16 и FP16 занимают по 16 бит: переход между ними сам по себе не удваивает память. Различаются диапазон значений и точность, поэтому совместимость и устойчивость вычислений нужно проверять отдельно.
Второе ограничение видно в официальном описании FlashAttention-2: стандартная CUDA-реализация ориентирована на Ampere, Ada и Hopper. Наличие слова Flash Attention в другом проекте не означает поддержку именно этой библиотеки на V100. У движка могут быть собственные реализации и запасные варианты; проверяйте тот путь, который реально используется при запуске.
Третье ограничение касается инструментов сборки. NVIDIA убрала офлайн-компиляцию и поддержку библиотек для Volta из CUDA Toolkit 13.0. Это не означает, что все ранее собранные программы мгновенно перестают работать. Но установка «самого нового CUDA» уже не является универсальным ответом на проблему старой карты: понадобится подходящая поддерживаемая комбинация версий.
У актуального vLLM минимальное требование к NVIDIA GPU — Compute Capability 7.5, тогда как у V100 оно 7.0. Для нового проекта на этой карте нельзя закладывать обычную установку свежего vLLM как готовый путь. Если рассматриваете старую версию или стороннюю сборку, учитывайте сопровождение и ограничения именно этой конфигурации.
В llama.cpp работа с Volta сохраняется, но это тоже не обещание беспроблемной установки любой версии. В сообщении пользователя проекта описана разница поведения одной и той же сборки исходников с CUDA 12.8 и 12.9 на V100. Это конкретный отчёт, а не универсальная рекомендация откатывать CUDA. Его практический смысл: требуйте воспроизводимый запуск нужной модели, а не фотографию карты в работающем сервере.
Если выбираете сервер для ИИ-ассистента, обсудите с PROMAREN сначала задачи и нагрузку, затем оборудование.
Покупайте результат проверки, а не только память
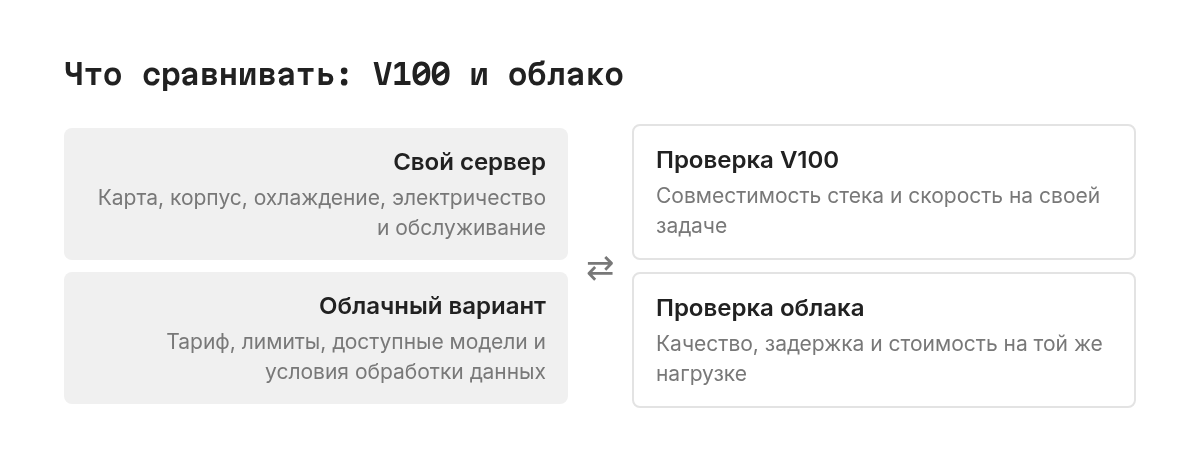
До покупки составьте небольшой набор своих заданий: документ для поиска, запись для расшифровки или типовые вопросы помощнику. Зафиксируйте модель, формат весов, размер контекста и число одновременных запросов. Сравнивайте одинаковые задания на предполагаемом сервере и в выбранном облаке.
Для диалогов измеряйте время до первого ответа и длительность ответа целиком. Для пакетной обработки — сколько документов или минут записи проходит за час. Одновременно проверяйте качество: более быстрый ответ бесполезен, если выбранная маленькая модель чаще ошибается на вашей терминологии. Сохраните и неудачные примеры, иначе демонстрация постепенно превратится в набор удобных для системы вопросов.
Отдельно проверьте нагрузку с тем количеством пользователей, которое планируется после запуска. Один короткий запрос может помещаться в память, а очередь длинных диалогов — уже нет. Полезно увидеть поведение при исчерпании памяти и перезапуске: запрос должен завершиться понятной ошибкой или повториться по правилам приложения, не исчезнуть молча.
Корпус и электричество входят в цену
PCIe-версия V100 использует пассивное охлаждение и рассчитана на организованный поток воздуха; это описано в руководстве NVIDIA по плате. Проверяйте корпус, питание, доступное место и температуру под длительной нагрузкой. Шум зависит от конкретной системы охлаждения, поэтому заранее объявлять любой сервер непригодным для офиса тоже неверно.
В смете нужны карта, остальная платформа, охлаждение, установка, обслуживание и резерв на отказ. У бывшего в употреблении оборудования состояние и условия гарантии особенно важны. Максимальная мощность из даташита не равна постоянному расходу из розетки: отдельно измерьте простой и характерную рабочую нагрузку всей машины.
Условный пример расчёта. Пусть весь сервер под нагрузкой потребляет 0,4 кВт, работает так 120 часов в месяц, а электричество стоит 8 ₽ за кВт·ч. Тогда активная работа даёт 0,4 × 120 × 8 = 384 ₽. Это придуманные исходные данные для объяснения формулы, не замер V100 и не тариф вашего региона. Добавьте потребление в остальные часы, охлаждение, обслуживание и стоимость оборудования, распределённую по выбранному сроку использования.
Не учитывайте охлаждение дважды. Если оно уже попало в измерение общего расхода, повторный коэффициент увеличит смету ошибочно. Для сравнения с облаком возьмите стоимость той же полезной нагрузки за месяц: нужное число ответов, обработанных документов или часов аудио с приемлемым качеством.
Когда собственная карта имеет смысл
V100 можно рассматривать, если подходящая модель уже проверена, нагрузка достаточно регулярна, а у команды есть возможность сопровождать сервер. Закрытый контур может быть отдельным требованием даже без денежной экономии. Тогда прямо сравнивайте способы выполнить это требование, вместо того чтобы обещать окупаемость любой ценой.
Если нагрузка нерегулярная или задачи требуют возможностей моделей, которые на выбранной конфигурации недоступны, облачный вариант может быть удобнее. Это нужно считать, а не объявлять заранее дешевле. Возможна и смешанная схема: локальная обработка определённого класса данных и внешние сервисы для разрешённых задач.
Сохраненный набор проверок, рабочие версии программ и расчет месячной нагрузки дают основание для покупки. Если продавец не может воспроизвести вашу задачу, сравните стоимость отдельной проверки с риском получить карту, которая подходит по памяти, но не подходит для нужного программного окружения.
AI-ассистенты: экономия 4 часа в день
RAG-помощник на ваших данных и регламентах
Первоисточники
- images.nvidia.comдаташите NVIDIA (откроется в новой вкладке)
- github.comофициальном описании FlashAttention-2 (откроется в новой вкладке)
- docs.nvidia.comубрала офлайн-компиляцию и поддержку библиотек для Volta из CUDA Toolkit 13.0 (откроется в новой вкладке)
- docs.vllm.aiактуального vLLM (откроется в новой вкладке)
- github.comсообщении пользователя проекта (откроется в новой вкладке)
- images.nvidia.comруководстве NVIDIA по плате (откроется в новой вкладке)
- promaren.ruИИ-ассистента под рабочий процесс (откроется в новой вкладке)

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


