


Когда мне приносят на согласование интеграцию с внешней языковой моделью, я прошу показать один настоящий запрос целиком, со всеми полями и в том виде, в котором он уходит из системы. Почти всегда в нем оказывается больше, чем предполагал сам разработчик, и это обычно становится для него новостью.
С DeepSeek API история повторяется: получить ключ и увидеть первый ответ модели можно за вечер, а вот понять, что именно вы отправили на чужой сервер, получается только тогда, когда садишься и читаешь тело запроса построчно. Ниже разбираю, куда смотреть, и отдаю чек-лист данных, который я прохожу перед любым запуском.
Что уходит вместе с одним вопросом
Модель видит все, что лежит в теле запроса, и ничего сверх того, поэтому граница утечки проходит ровно по тому, что ваш код туда положил. Трудность в том, что код кладёт туда гораздо больше, чем пишет человек в окне чата.
В документации DeepSeek по многошаговому диалогу прямо сказано, что сервер не хранит историю разговора между вызовами, и приложение само собирает всю переписку и отправляет её заново вместе с каждым новым сообщением.
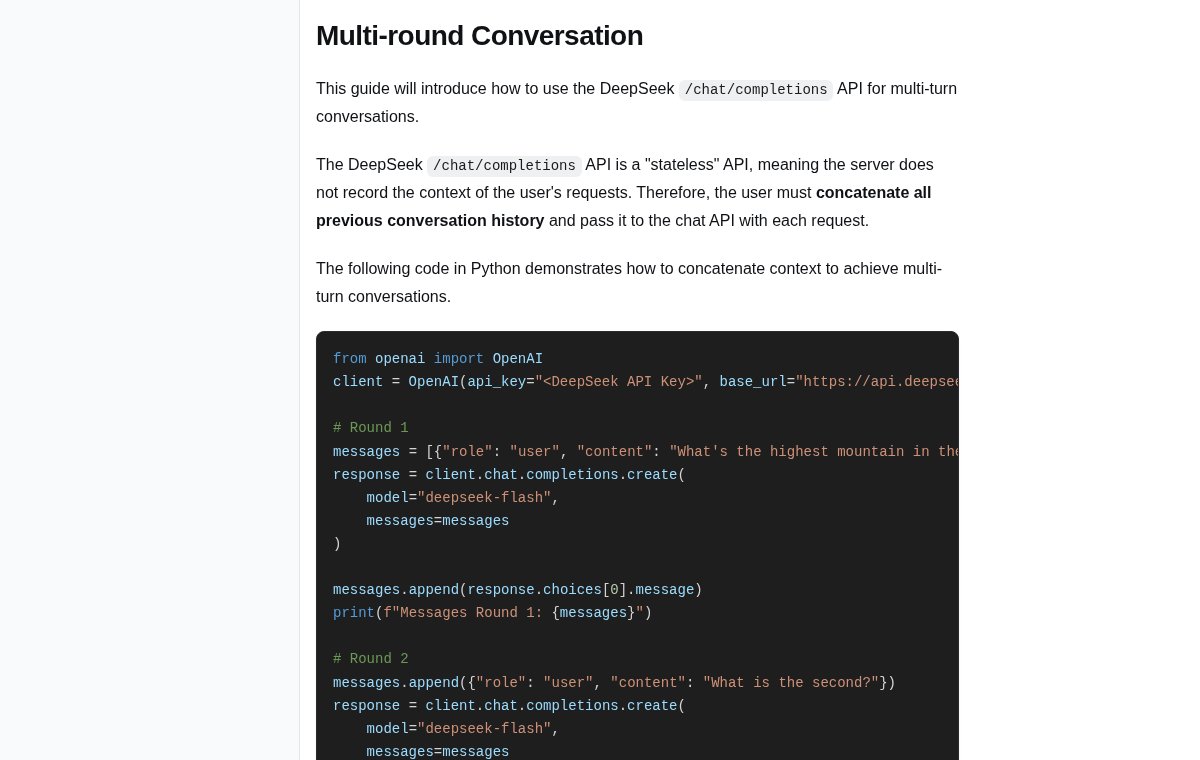
На практике это значит, что номер договора, который клиент назвал в первой реплике, уедет на сервер и во втором, и в десятом запросе, пока диалог не закончится, и вычеркнуть его из уже отправленного потока никто не сможет.
Поэтому я смотрю на запрос как на четыре слоя и проверяю каждый отдельно, потому что утекает обычно тот, о котором все забыли, пока обсуждали качество ответов.
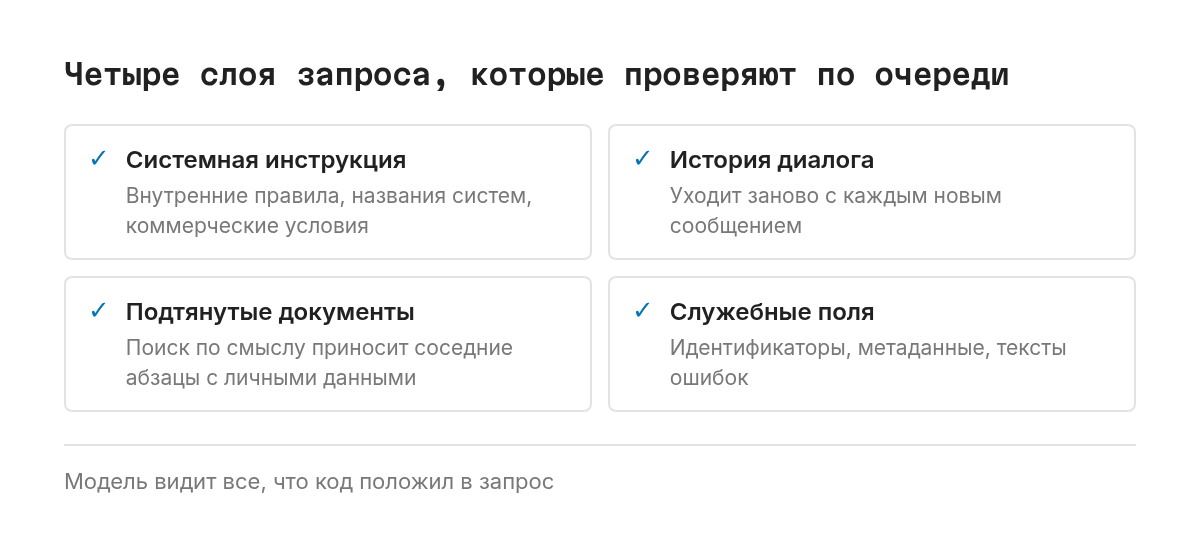
Системную инструкцию пишут один раз и перестают на неё смотреть, а внутрь со временем вшивают внутренние правила, названия систем, условия скидок и фрагменты регламентов, которые никто не собирался показывать наружу.
Документы, которые подтягивает поиск по базе знаний, опаснее всего остального: выдача настраивается по смыслу, и в контекст легко попадает соседний абзац с паспортными данными или зарплатой, если он оказался похож на вопрос пользователя.
Служебные поля выглядят безобидно, пока в них не заглянешь: туда попадают идентификаторы клиентов, адреса почты из профиля и тексты ошибок, в которых иногда целиком печатается строка подключения к базе данных.
Где оседают данные после отправки
Второй вопрос, который я задаю на согласовании, звучит скучно, но важнее его мало что есть: где физически лежит то, что мы отправили. В политике конфиденциальности DeepSeek указано, что собранная информация хранится на серверах в Китайской Народной Республике.
Для российской компании это означает трансграничную передачу, и если в запросе окажутся персональные данные клиентов или сотрудников, у вас появляются обязанности по закону о персональных данных, которые в пятничном прототипе точно никто не закрывал.
Есть и менее заметная деталь, которую находят только те, кто дочитывает документацию: в разделе про кеширование контекста сервис описывает механизм сохранения повторяющихся начал запросов, который нужен, чтобы отвечать быстрее и дешевле.
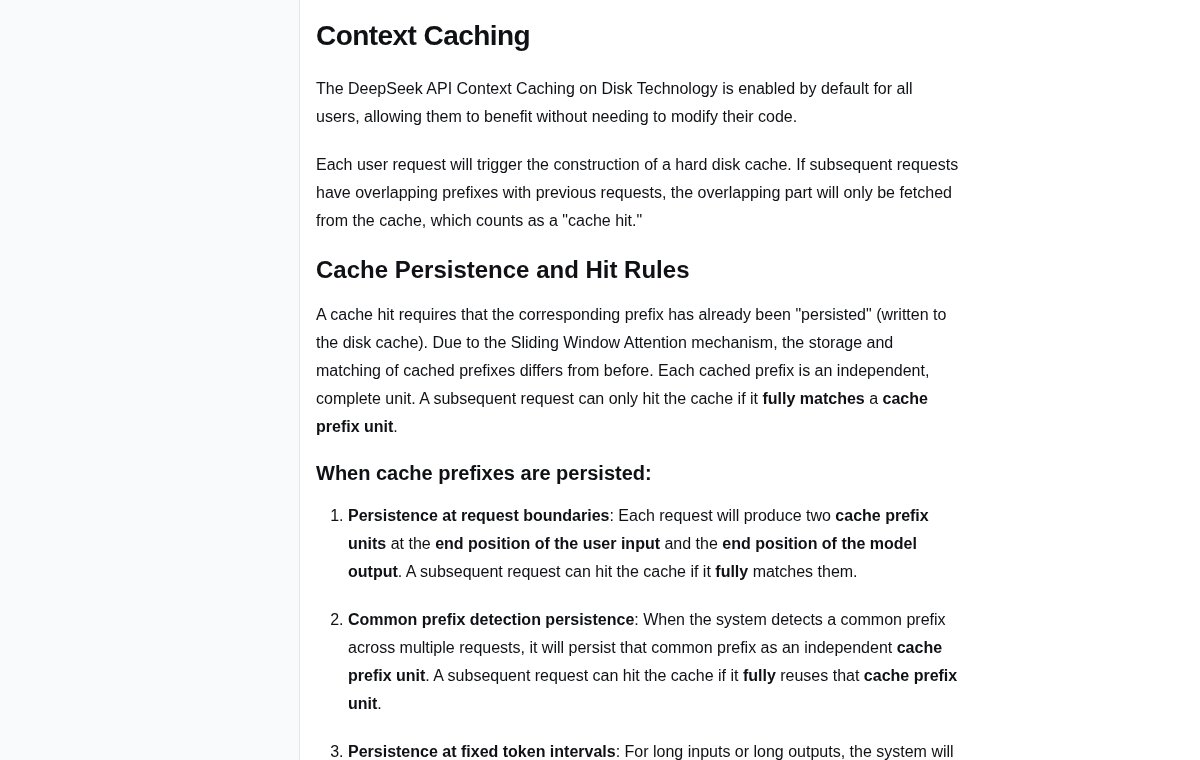
Для бюджета это приятная новость, а для данных она означает простую вещь: длинная системная инструкция с внутренними правилами, которая повторяется в каждом вызове, какое-то время лежит на чужих дисках, даже когда сам разговор давно закончен.
Поэтому я делю все поля запроса на три цвета и принимаю решение по цвету до того, как появляется код интеграции, потому что потом это решение молча принимает сам код.
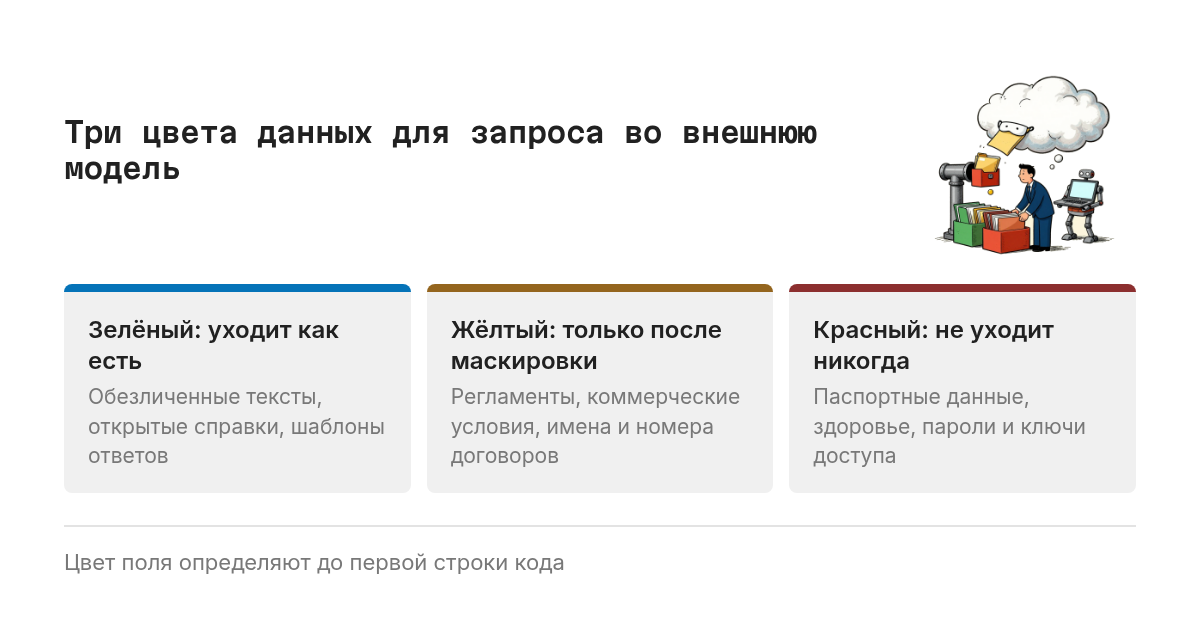
Красный цвет в этой схеме нельзя "временно" перекрасить в жёлтый ради демонстрации руководству, потому что временные решения в интеграциях живут дольше постоянных.
Как устроен контур, в котором ничего лишнего не уходит
Надёжная схема держится на одном правиле: приложение никогда не ходит в DeepSeek напрямую, между ним и внешней моделью стоит ваш собственный шлюз, через который проходит каждый запрос без исключений.
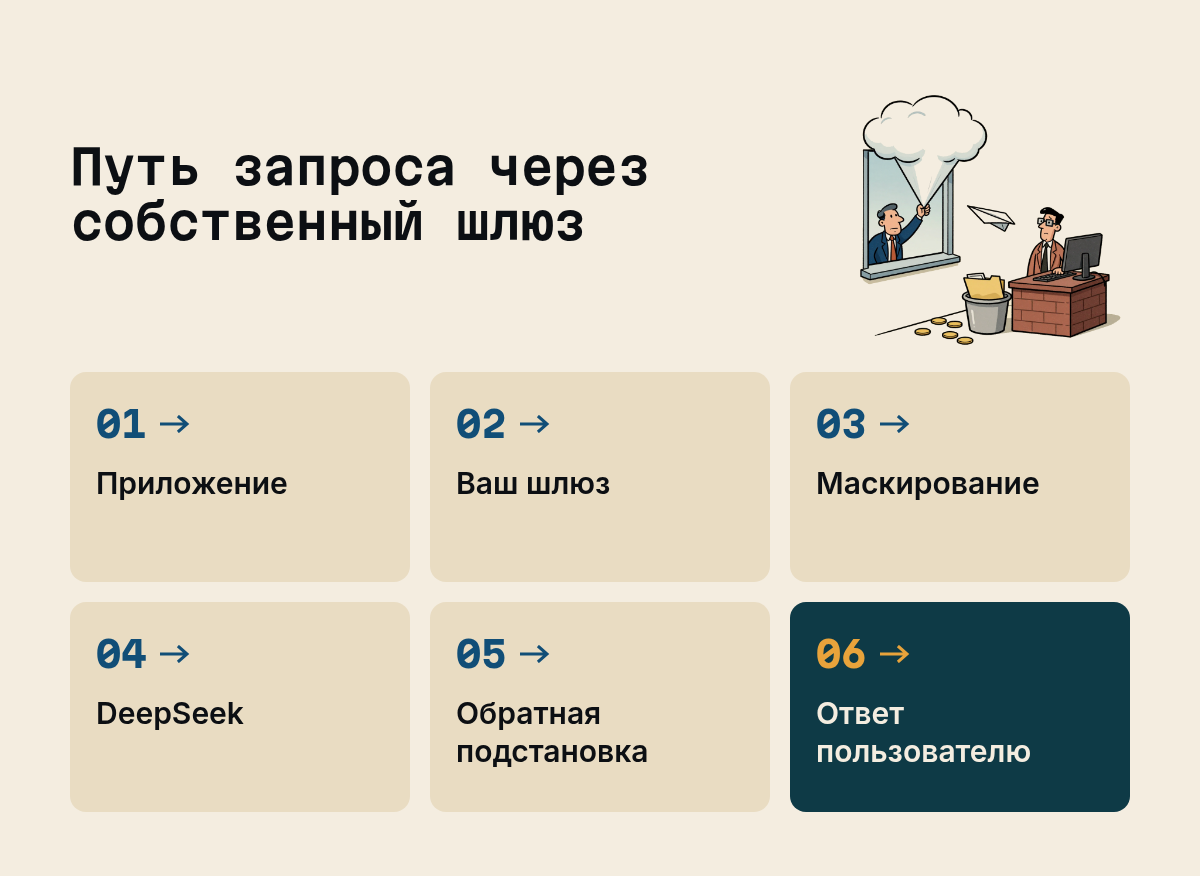
Механика простая: приложение → ваш шлюз → маскирование → DeepSeek → обратная подстановка → ответ пользователю. Шлюз заменяет телефоны, имена и номера договоров на метки вида [КЛИЕНТ_1], отправляет наружу обезличенный текст и возвращает настоящие значения уже внутри вашего контура.
Модели для хорошего ответа почти никогда не нужно знать, что клиента зовут именно так и что его телефон заканчивается на конкретные цифры, ей достаточно понимать, что это клиент и у него есть телефон.
Второе, что даёт шлюз, это журнал: вы храните у себя, что именно и когда ушло наружу, и при проверке можете показать записи, вместо того чтобы восстанавливать события по памяти разработчика, который к тому времени уже в другом проекте.
Аудитор во мне отдельно любит журнал, потому что без него ответ на вопрос "что мы отправили" обычно звучит как "вроде ничего такого".
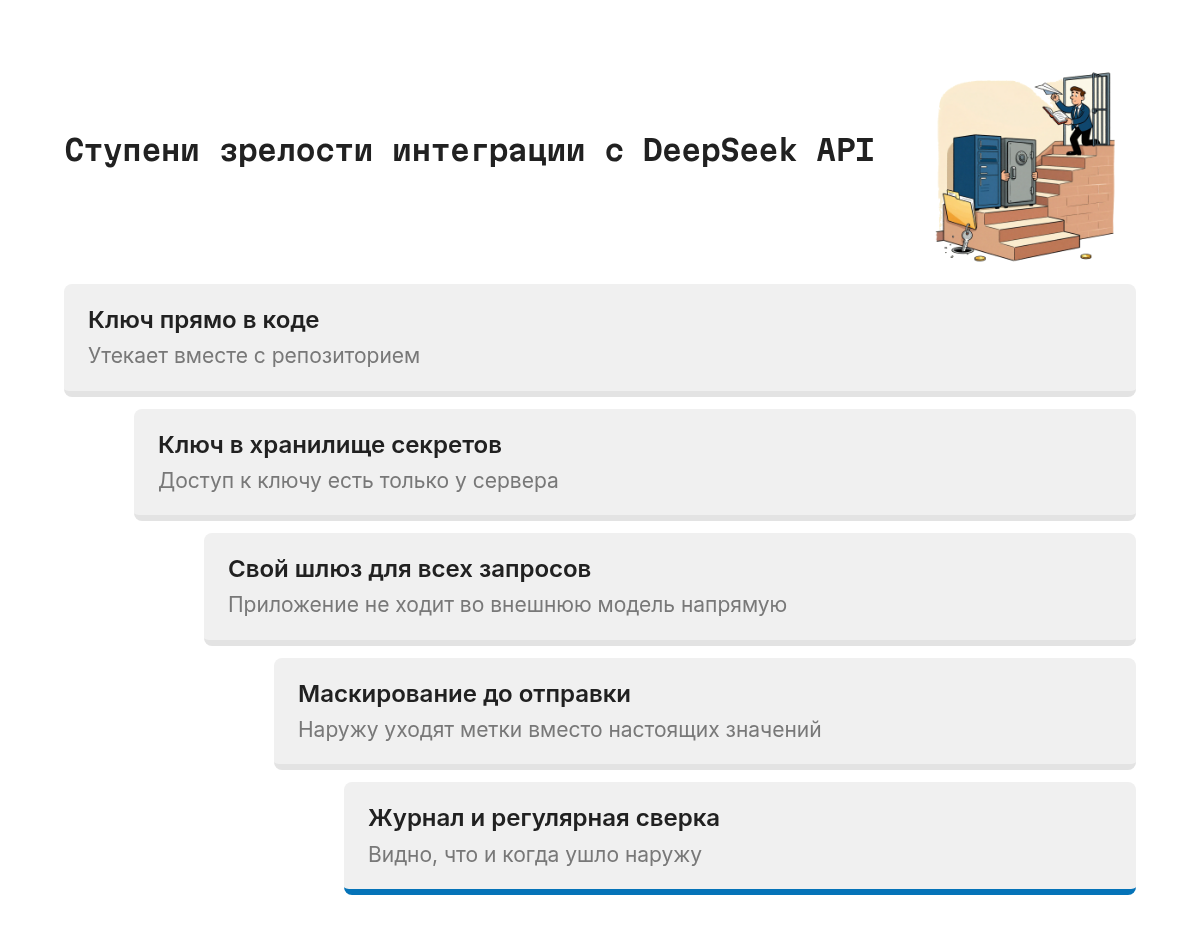
Ключ API в этой схеме живёт только на шлюзе, в хранилище секретов, и никогда не попадает в браузер, в мобильное приложение или в репозиторий, откуда его однажды достанут вместе со всей историей изменений.
Зрелость такой интеграции удобно мерить ступенями, и честная самооценка часто показывает первую или вторую, хотя по ощущениям команды компания давно стоит на четвертой.
Чек-лист данных перед подключением DeepSeek API
Этот список я прохожу до того, как интеграция увидит первого живого пользователя, и каждый пункт в нем можно проверить руками и отметить.
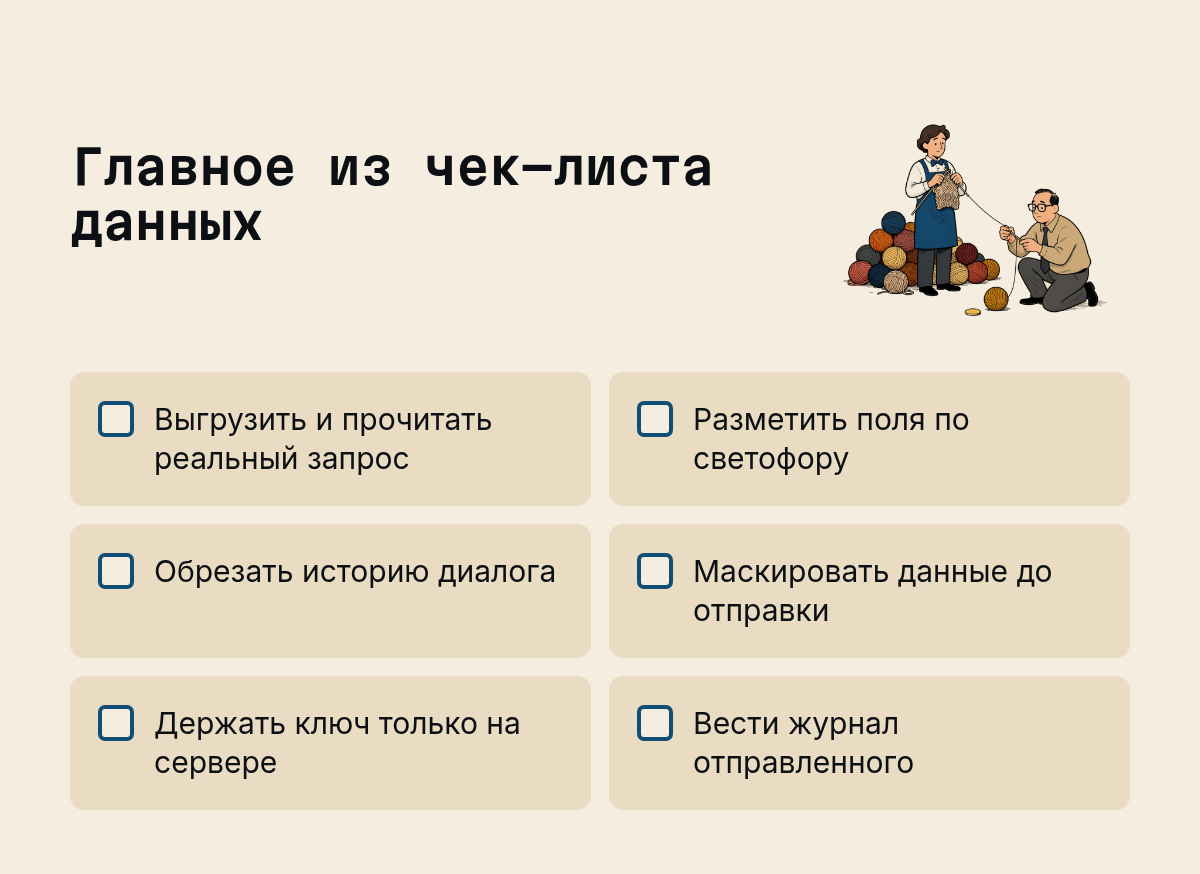
- Выгрузите один реальный запрос к DeepSeek API целиком и прочитайте каждое поле, включая системную инструкцию, историю диалога и служебные поля.
- Составьте список полей, которые код добавляет в запрос автоматически, и для каждого запишите, зачем оно нужно модели для ответа.
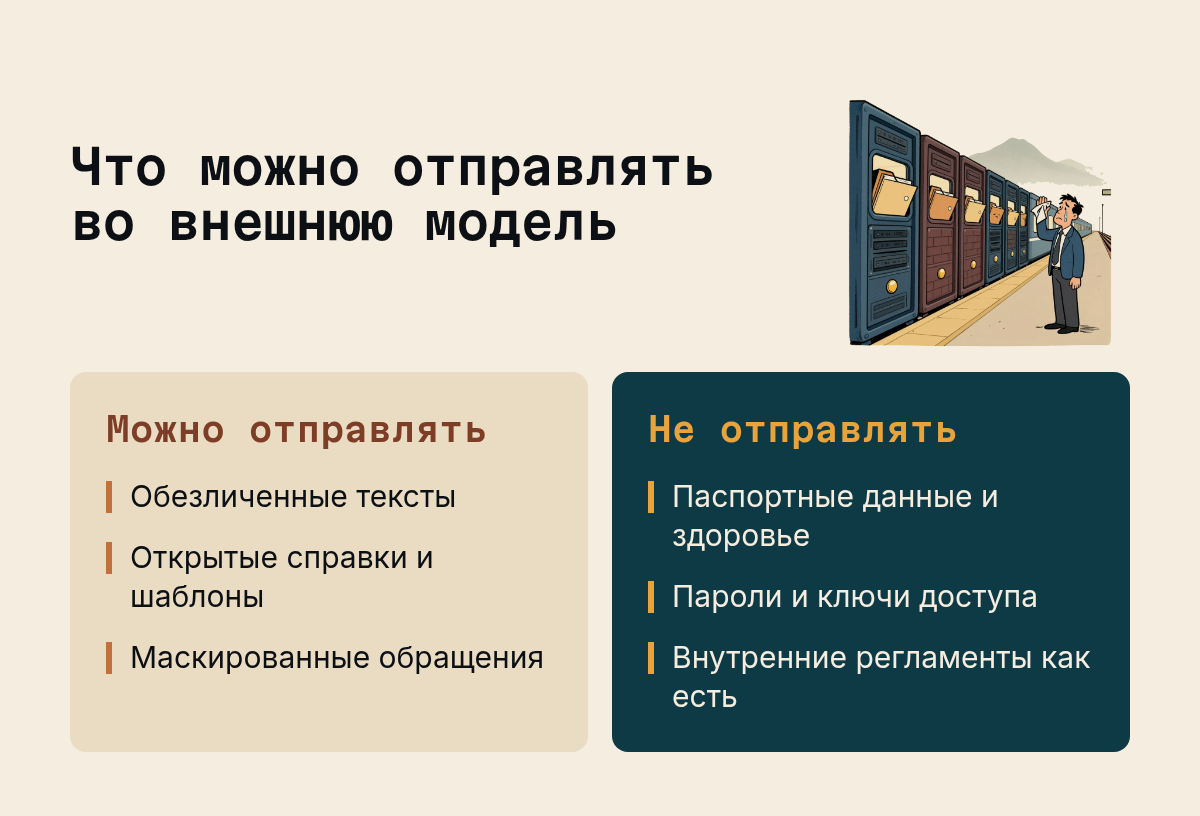
- Разметьте поля по светофору: зелёные уходят как есть, жёлтые только после маскировки, красные не уходят во внешнюю модель вообще.
- Проверьте системную инструкцию на внутренние названия систем, коммерческие условия и фрагменты регламентов, которые можно заменить общими формулировками.
- Ограничьте историю диалога только теми репликами, которые нужны для текущего ответа, и настройте обрезку старых сообщений.
- Прогоните типовые вопросы через поиск по базе знаний и посмотрите, не попадают ли в выдачу соседние абзацы с персональными данными.
- Включите маскирование телефонов, почты, имён, номеров документов и договоров до отправки, с обратной подстановкой на своей стороне.
- Убедитесь, что пароли, ключи доступа и строки подключения отсекаются фильтром и не попадают в запрос даже через тексты ошибок.
- Храните ключ API только на сервере в хранилище секретов и проверьте репозиторий и его историю на случайно сохранённые ключи.
- Заведите отдельный ключ под каждую систему, чтобы отозвать один из них без остановки остальных интеграций.
- Ведите на своём шлюзе журнал отправленного с маскированными значениями и заранее определённым сроком хранения записей.
- Согласуйте с юристом трансграничную передачу и обновите политику обработки данных, если какие-то персональные данные все же уходят наружу.
- Назначьте ответственного за регулярную сверку журнала с разметкой полей, потому что новые поля появляются в запросе вместе с каждой доработкой.
Если после этого списка стало понятно, что шлюз с маскированием и журналом нужен под вашу систему, такие интеграции я собираю кодом на Python и TypeScript и начинаю всегда с того же самого: с одного настоящего запроса, прочитанного построчно.
Частые вопросы про DeepSeek API и данные
Можно ли отправлять персональные данные в DeepSeek API?
Как есть я бы их не отправляла, потому что политика конфиденциальности сервиса говорит о хранении данных на серверах в Китае, а для российской компании это трансграничная передача со своими обязанностями. Надёжнее маскировать данные на собственном шлюзе до отправки и возвращать настоящие значения уже внутри вашего контура.
Хранит ли DeepSeek API историю переписки?
Между вызовами сервер историю диалога не хранит, и приложение само отправляет всю переписку заново вместе с каждым новым сообщением. Отсюда практическое следствие: данные из первой реплики уходят во всех следующих запросах этого диалога, поэтому историю стоит обрезать и маскировать.
Где хранить ключ DeepSeek API?
Ключ хранят только на сервере, в хранилище секретов, и не кладут ни в браузер, ни в мобильное приложение, ни в репозиторий. Под каждую систему удобно заводить отдельный ключ, чтобы при утечке отозвать его и не останавливать все остальные интеграции разом.
Как понять, что уходит в DeepSeek API из моего приложения?
Проще всего выгрузить один реальный запрос целиком и прочитать каждое поле: системную инструкцию, историю диалога, подтянутые документы и служебные поля. Дальше эту работу берет на себя журнал на собственном шлюзе, где видно, что и когда ушло наружу.
Что проверить сегодня самому
Попросите разработчика показать вам один настоящий запрос к модели, без пересказа и без презентации, и прочитайте его сами, даже если вы далеко от кода. Если вы нашли в нем хотя бы одно поле, назначение которого никто не может объяснить, первый пункт чек-листа уже окупился.
Затем откройте системную инструкцию и представьте, что её перешлют вашему конкуренту целиком: все, из-за чего вам стало бы неуютно, из неё стоит убрать или заменить общими словами.
А какой слой запроса в вашей интеграции вы проверяли последним, и проверяли ли его вообще?
Новые разборы выходят в моём канале: t.me/promaren.
AI-ассистенты: экономия 4 часа в день
RAG-помощник на ваших данных и регламентах
Первоисточники


Частые вопросы
Можно ли отправлять персональные данные в DeepSeek API?
Лучше не отправлять их как есть. Политика конфиденциальности сервиса говорит о хранении данных на серверах в Китае, поэтому для российской компании это трансграничная передача. Надёжнее маскировать данные на своём шлюзе до отправки.
Хранит ли DeepSeek API историю переписки?
Сервер не хранит историю диалога между вызовами, приложение само отправляет всю переписку заново с каждым сообщением. Поэтому данные из первой реплики уходят во всех следующих запросах этого диалога.
Где хранить ключ DeepSeek API?
Только на сервере, в хранилище секретов. Ключ не должен попадать в браузер, мобильное приложение или репозиторий, а под каждую систему удобно заводить отдельный ключ, чтобы отзывать его без остановки остальных.
Как понять, что уходит в DeepSeek API из моего приложения?
Выгрузить один реальный запрос целиком и прочитать каждое поле: системную инструкцию, историю диалога, подтянутые документы и служебные поля. Дальше помогает журнал на собственном шлюзе.

Марина Погодина, основатель PROMAREN
17 лет в ИТ и управлении технологическими рисками, из них 14 лет в аудите ИТ и внутреннем контроле. Более 60 аудитов ИТ и информационной безопасности.


